Garantire sovranità e affidabilità a ogni livello ha richiesto di costruire competenze tecniche lungo tutto lo stack, un percorso in cui NVIDIA è stata un partner chiave.
Concentrandoci sul livello dei modelli: l’investimento tempestivo di NVIDIA sull'open source ci ha permesso di non partire da zero. NVIDIA aveva già reso open source gran parte dello stack di training, sul quale abbiamo costruito sia i nostri modelli general-purpose sia quelli specializzati. Quanto segue racconta come questa collaborazione ha plasmato il nostro processo e perché le organizzazioni che cercano di costruire una propria AI sovrana non devono, nemmeno loro, partire da zero.
I primi passi
In Domyn abbiamo iniziato a sviluppare i nostri modelli nel 2023. Il primo è stato Italia 9B, un modello della generazione di Llama 2. Per il training abbiamo usato LitGPT, un framework open source molto diffuso per l'addestramento e il fine-tuning di LLM.
Il mix di dati era deliberatamente sbilanciato verso fonti italiane, per eguagliare la qualità raggiunta all'epoca dai modelli specializzati su una singola lingua. Ma soprattutto, questa prima esperienza ci ha permesso di mettere a punto una prima versione delle nostre pipeline di curation, pretraining, instruction tuning ed evaluation.
Allo stesso tempo, dato che il modello mancava di capacità più generali, è diventato chiaro che avevamo bisogno di dataset più estesi e di maggiore scala. Le abbiamo trovate entrambe adottando NeMo, lo stack open source di NVIDIA, che ha aperto la strada ai nostri modelli successivi: Italia 10B e Colosseum 355B.
Scalare grazie a NeMo, lo stack open source di NVIDIA
La collaborazione con NVIDIA si è rivelata decisiva durante tutta la fase di scaling dei modelli. La libreria NVIDIA Megatron-Core rappresentava lo stato dell'arte dell'epoca, pensata per garantire capacità di elaborazione e stabilità a una scala operativa che pochissime organizzazioni erano in grado di raggiungere. Su questa base abbiamo costruito Italia 10B e Colosseum 355B, adottando un'architettura, un tokenizer e una strategia sui dati comuni a entrambi i modelli.
Colosseum 355B, nello specifico, puntava a capacità multilingue su scala frontier, con un vocabolario di 256k token, oltre 50 lingue supportate e una deliberata sovra-rappresentazione delle lingue europee.
Colosseum 355B ci ha permesso di sviluppare direttamente competenze di training distribuito su larga scala. La vera sfida, in questo caso, è stata la gestione del checkpointing distribuito: i file system paralleli cedevano in modi difficili da individuare, finché centinaia di nodi non li sollecitavano insieme e bastava un solo nodo degradato per rallentare l'intero job sincrono.
In questo contesto, lo stack di NVIDIA — testato sul campo — ci ha aiutato ad affrontare i problemi che stavamo incontrando. Ci ha permesso di superare il 40% di MFU attraverso la riorganizzazione del parallelismo tra le GPU, l'esecuzione parallela di calcolo e comunicazione, e il training in FP8 sui primi cluster Hopper.
Il lavoro sul multilinguismo ci ha permesso di trasformare il data processing in un'operazione su scala industriale, setacciando centinaia di terabyte di testo grezzo in oltre 50 lingue. È stato anche il momento in cui abbiamo gettato le basi per la conformità alla direttiva UE sul copyright e agli obblighi dell'AI Act europeo. Lo abbiamo fatto tramite classificatori ML e sistemi a regole per analizzare interi dataset testuali, meccanismi di tracciamento della provenienza dei dati, e il rigoroso rispetto delle richieste di opt-out.
In parallelo, è cresciuta rapidamente anche la nostra capacità di valutare i modelli. Abbiamo costruito Domyn Swarm per eseguire inferenza alla scala di un modello come Colosseum, su infrastrutture HPC, rilasciandolo come progetto open source. Per la prima volta abbiamo sviluppato una nostra suite di valutazione, Domyn Eval, che estende framework già diffusi come NVIDIA NeMo Gym (in precedenza conosciuto come NeMo Evaluator) e, dove possibile, riutilizza benchmark esistenti. In altri casi abbiamo costruito benchmark proprietari: Evalita-LLM è nato in collaborazione con FBK e l'Università di Torino. Ci siamo inoltre affidati a valutazioni personalizzate su task enterprise come text-to-SQL, text-to-Cypher, estrazione di triple da knowledge graph e classificazione di conformità normativa.
L'avvento del "thinking"
Nel 2025 il "thinking" ha fatto il suo ingresso nei modelli frontier. Colosseum 355B era un modello capace, ma era stato addestrato a rispondere "di getto", senza ragionamenti intermedi e quindi senza sfruttare la capacità di calcolo aggiuntiva in fase di inferenza offerta da questo nuovo meccanismo. Il “thinking” ha portato con sé la necessità di un contesto più esteso rispetto a quello originario di Colosseum. E poiché ogni risposta richiedeva un numero di token generati più alto, il costo per token doveva necessariamente scendere per restare sostenibile.
Colosseum 355B restava un modello solido. Lo abbiamo quindi usato come base per costruirne uno nuovo, che rispondesse a tutte queste esigenze. È così che è nato Domyn Large.
Domyn Large
Il primo passo per costruire Domyn Large è stato ridurre, tramite pruning, i 355 miliardi di parametri di Colosseum a 263 miliardi. Il secondo è stato riaddestrare il modello ridotto per distillazione, così da recuperare le capacità perse nel pruning.
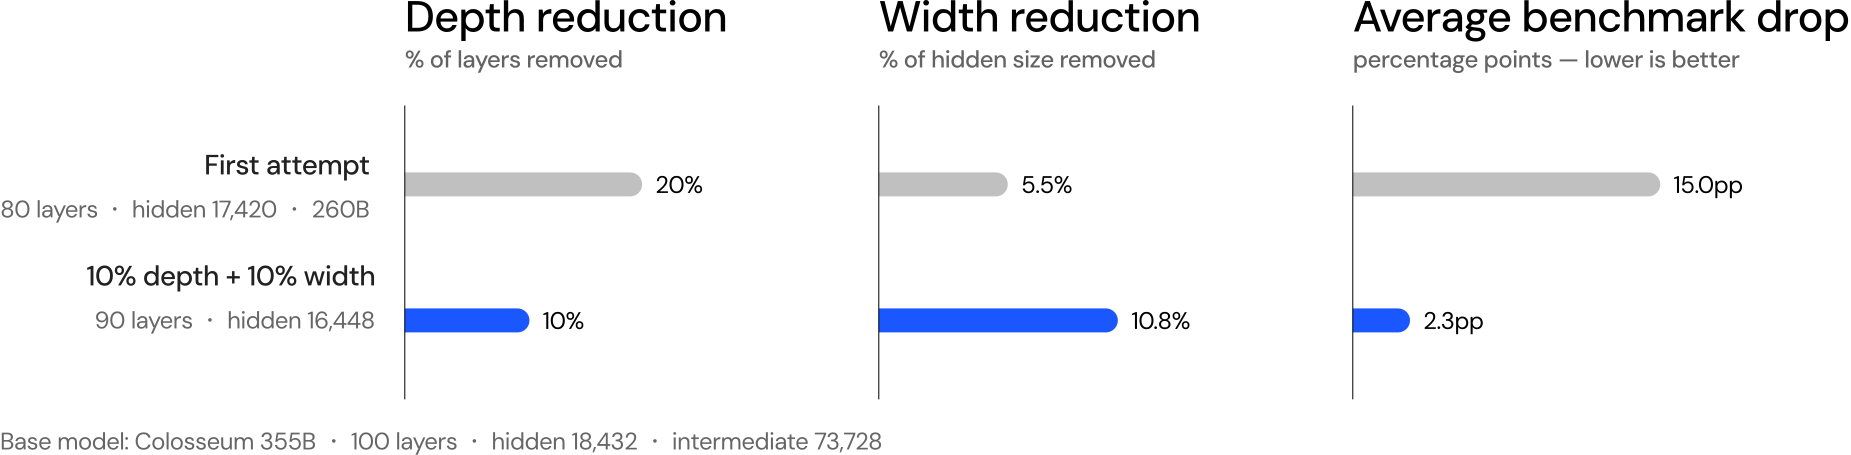
Al primo tentativo abbiamo tagliato un quinto dei layer e distillato per 1.000 step, il che ha portato a un calo nelle prestazioni di circa 15 punti percentuali, senza alcun recupero. Abbiamo quindi cambiato approccio, distribuendo la riduzione dei parametri in modo uniforme: 10% in profondità e 10% in ampiezza, con un calo nelle prestazioni di soli 2,3 punti percentuali nella versione finale. Suddividere il processo di pruning in due cicli sequenziali di minore entità non ha portato invece benefici misurabili rispetto ad eseguire la riduzione in un solo passaggio. Abbiamo inoltre riscontrato che il bilanciamento migliore per la loss di training era 0,2 per la distillazione e 0,8 per il language modeling, e che il recupero delle prestazioni perse con il pruning raggiunge il massimo già dopo pochi cicli di training. Gli effetti del pruning sulla nostra suite di benchmark, però, non erano uniformi: i task multilingue e di coding erano quelli più colpiti, mentre i benchmark orientati alla conoscenza come MMLU risultavano solo minimamente compromessi. La vera sfida non era solo decidere quanto ridurre il modello, ma anche a quali capacità dare priorità nel recupero.
Una volta ridotto il modello, abbiamo spinto ulteriormente l'estensione del contesto attraverso un pretraining esteso su contesti lunghi, aumentando gradualmente la lunghezza delle sequenze secondo uno schema prestabilito. Questa fase ha permesso a Domyn Large di superare le prestazioni di Colosseum.
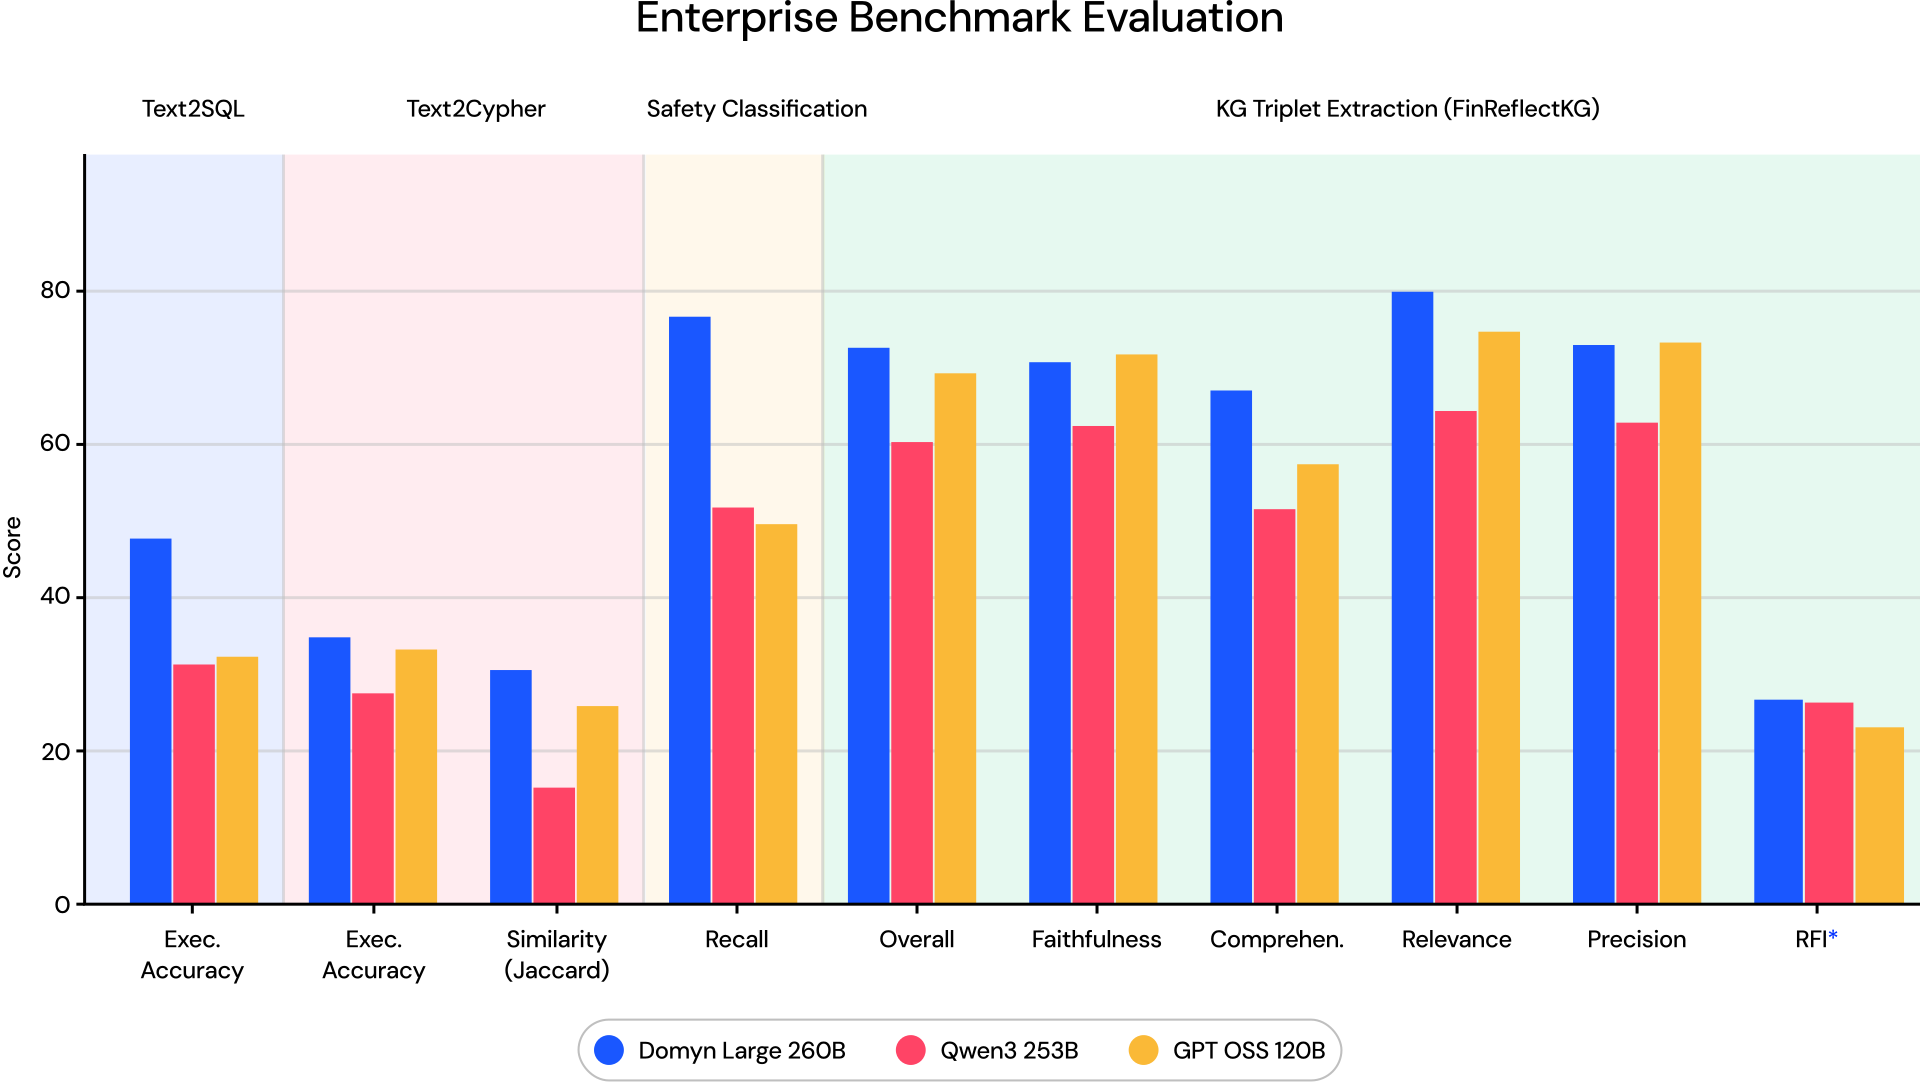
Domyn Large ha registrato la massima accuratezza di esecuzione proprio sui task enterprise già citati, text-to-SQL e text-to-Cypher, superando i modelli concorrenti Qwen3 253B e GPT-OSS 120B.
L'intero processo ha richiesto circa mezzo miliardo di token per la distillazione e 50 miliardi di token per il pretraining esteso, contro gli 11.000 miliardi di token usati per addestrare il modello base. NVIDIA ci ha supportato con framework di ricerca come Minitron e Puzzle, compresi in NVIDIA Model Optimizer, che abbiamo anche contribuito a estendere e adattare alle nostre esigenze.
Oltre a ottenere un modello estremamente capace da utilizzare nelle nostre applicazioni verticali per i clienti, l'esperienza fatta con Domyn Large ha dimostrato che siamo in grado di indirizzare efficacemente i modelli verso l'acquisizione di capacità che originariamente non possedevano. Ancora una volta, la chiave per raggiungere questi risultati è stata una solida strategia di gestione dei dati e una strategia di valutazione dei modelli ancora più solida.
Domyn Small
Dopo il rilascio di Domyn Large, abbiamo lavorato alla costruzione di un modello multilingue solido e più piccolo per lo scenario emergente degli agenti autonomi. Idealmente, un erede del modello Italia 10B da utilizzare per specializzazioni verticali nei casi d'uso dei nostri clienti.
Poiché il modello doveva possedere forti capacità di agire autonomamente per portare a termine compiti specifici, ci siamo concentrati molto sulla fase di post-training. Domyn Small è stato costruito a partire da Italia 10B attraverso una pipeline multi-stadio: pretraining esteso per ampliare la finestra di contesto, fine-tuning supervisionato (SFT) per insegnare i task specifici, e infine reinforcement learning (RL) per rendere il modello estremamente affidabile nell'eseguirli.
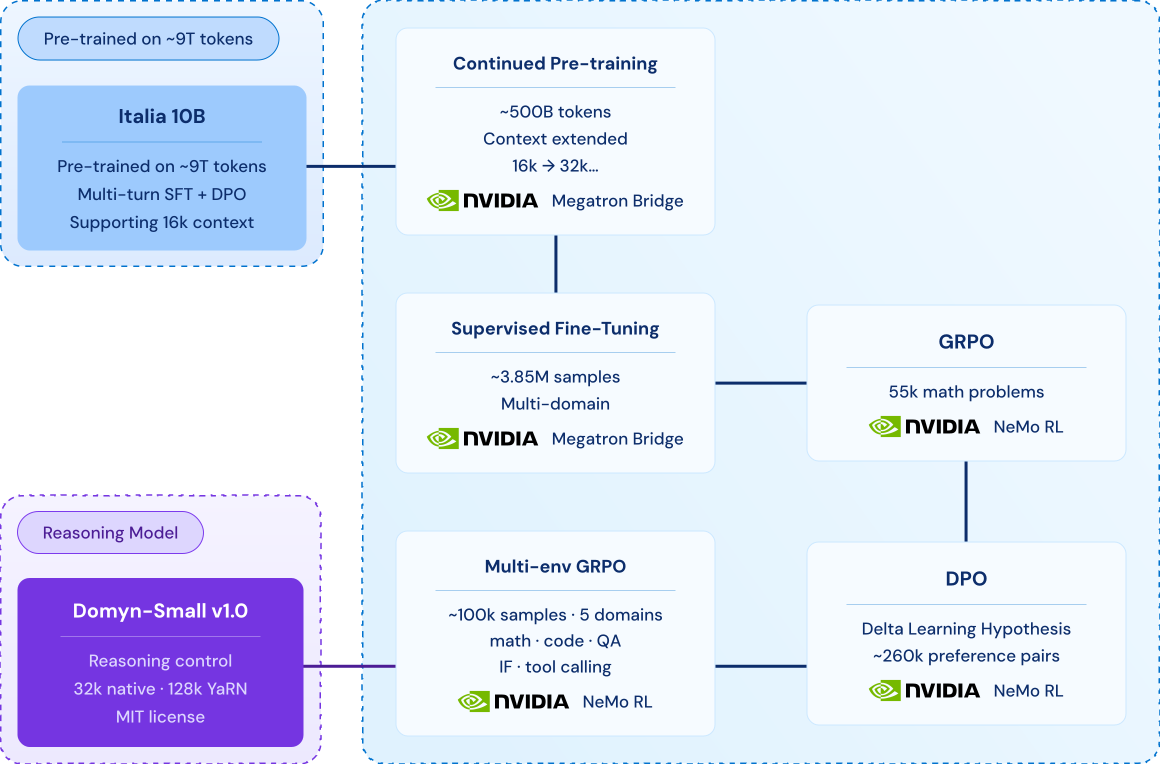
Terminato il pretraining esteso, è stato il fine-tuning supervisionato a restituire i risultati più significativi. Dopo decine di run di training completi con mix di dati diversi è emerso un pattern costante: mescolare diversi domini nello stesso set di training significava accettare un compromesso strutturale, non risolvibile semplicemente regolando gli iperparametri. Oltre una certa quantità di esempi, i due domini, matematica e codice, iniziavano a interferire tra loro: qualunque combinazione si scegliesse, le prestazioni ne risentivano in almeno una delle due aree. Questo ci ha portato all'approccio attuale: addestrare "teacher" specializzati per singolo dominio, per poi combinarli tramite distillazione on-policy multi-teacher.
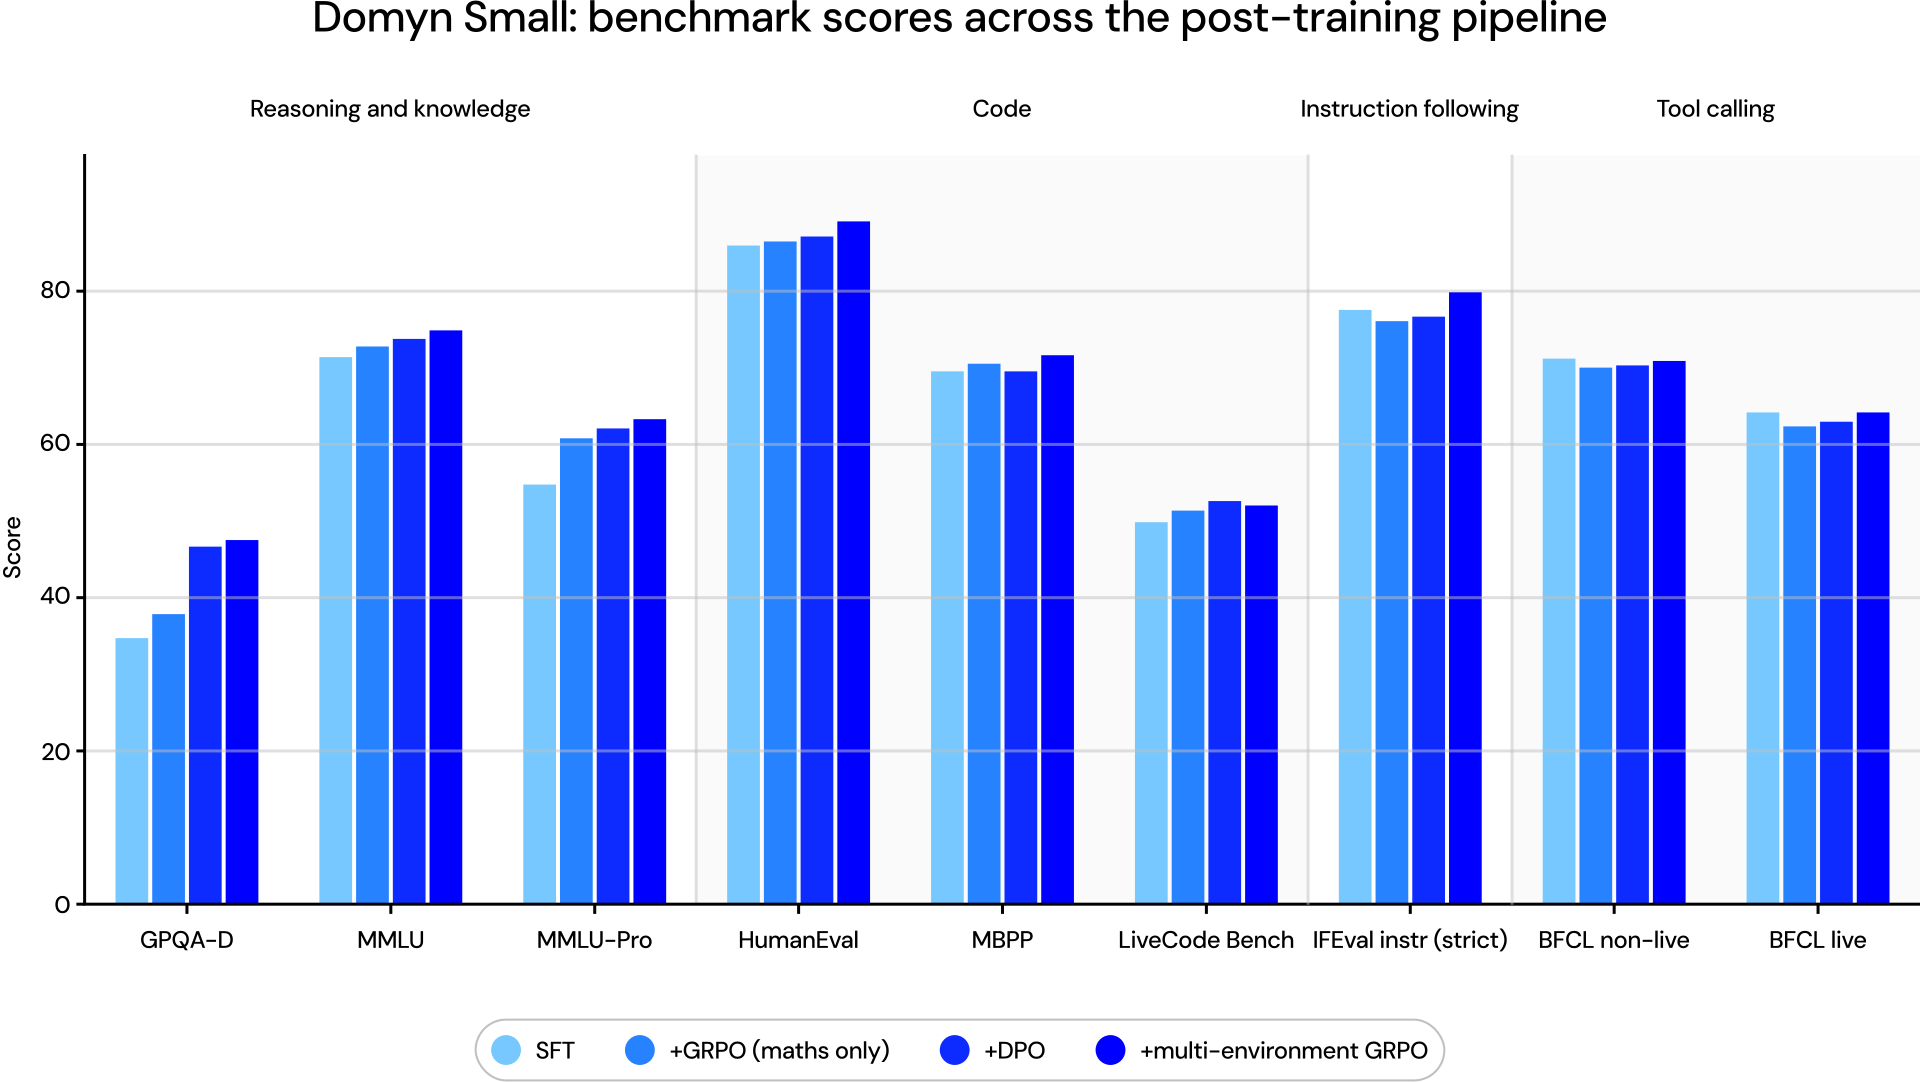
Nella fase successiva abbiamo usato il reinforcement learning per eseguire Group Relative Policy Optimization (GRPO) su più ambienti con reward verificabili in modo oggettivo. A questo abbiamo affiancato tecniche di preference optimization.
Da questo lavoro sono emersi due risultati chiave. Primo: la scelta del learning rate doveva precedere ogni altra decisione sugli iperparametri. Il GRPO si era mostrato sensibile a una cattiva impostazione del learning rate, con divergenze che potevano manifestarsi anche tardi nel training; warmup estesi mascheravano questa instabilità, invece di mitigarla. Una ricerca sistematica del learning rate richiedeva quindi un warmup breve. Questo risultato contrastava nettamente con quanto emergeva dalla fase di fine-tuning supervisionato (SFT), dove le variazioni di learning rate producevano differenze trascurabili nei risultati.
Secondo: le funzioni specifiche di SFT e RL andavano tenute nettamente distinte. Il reinforcement learning aveva migliorato l'affidabilità del pass@1, ma non aveva ampliato il tetto delle capacità: a pass@1024, i modelli ottimizzati con RL non risolvevano problemi aggiuntivi rispetto al modello base, indipendentemente dall'algoritmo usato (si veda "Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?", arXiv:2504.13837). L'implicazione pratica è stata una chiara divisione del lavoro: massimizzare il pass@k durante il fine-tuning supervisionato, dove si acquisiscono nuove capacità, per poi applicare il reinforcement learning e sfruttare quella capacità per ottenere affidabilità sul pass@1. A differenza del RL, l'SFT aveva un impatto sulla curva del pass@k — la stessa ragione per cui, come visto sopra, conveniva investire nell'addestramento di teacher specializzati per dominio.
Il contributo di NVIDIA
Lo stack tecnologico di NVIDIA ci ha aiutato due volte in questo processo. Primo: con NVIDIA NeMo RL abbiamo avuto a disposizione una libreria open-source di reinforcement learning pensata per il training distribuito con generazione in tempo reale delle risposte, che in seguito abbiamo fatto evolvere nel nostro stack Domyn RL.
Secondo: il dataset open di post-training di NVIDIA, rilasciato insieme ai modelli Nemotron, ha ridotto sensibilmente i nostri costi di generazione di dati sintetici. Questo dataset offriva una copertura ampia e di alta qualità su task di matematica, codice, catene di reasoning e instruction following, permettendoci di concentrare la nostra attività di generazione di dati sintetici (SDG) esattamente sui gap identificati dalle nostre valutazioni.
Tutto il lavoro è stato eseguito sul supercomputer Leonardo, l'infrastruttura europea di calcolo gestita dal CINECA. Il risultato è un modello che raggiunge una performance paragonabile a Qwen 3.5 9B su diversi task di reasoning, producendo circa il 33% di token in meno. Questo guadagno di efficienza si riassume in una metrica, l'accuratezza per token, che è stata poi adottata da altri team per misurare l'efficienza dei modelli.
Abbiamo rilasciato il modello in modo aperto, con licenza MIT, all'inizio del 2026, insieme a pesi, ricetta di training e dettagli sui dati, come documentato nel Domyn Small Technical Report.
Lungo tutto il processo, abbiamo garantito la piena conformità di tutti i nostri modelli all'AI Act europeo. In particolare, a marzo 2026 abbiamo sottoposto all'AI Office della Commissione Europea un Safety and Security Model Report completo per Domyn Large.
Cosa viene dopo
Guardando al futuro, due sviluppi interessanti sono già in cantiere.
Il primo è il rilascio di Domyn Edge, un modello fortemente agentico da 4B di parametri con una lunghezza di contesto di 1M di token, addestrato da zero su oltre 13.000 miliardi di token. Per costruirlo abbiamo adottato scelte architetturali mirate e le metodologie più avanzate allo stato dell'arte. Domyn Edge sarà rilasciato a ottobre 2026, e i primi risultati ci entusiasmano molto.
Con Domyn Edge, la nostra gamma di modelli si arricchirà di un'opzione altamente personalizzabile, distribuibile in modo flessibile dietro un endpoint o on-device, in grado di gestire task altamente specializzati e che richiedono molti passaggi in sequenza per essere completati.
La seconda iniziativa in corso è EUROPA, un modello di frontiera open-source, addestrato su infrastruttura europea e sviluppato insieme al Fraunhofer Institute nell'ambito dell'European AI Grand Challenge. Il rilascio è previsto per la seconda metà del 2027 e rappresenterà uno sforzo senza precedenti su infrastruttura UE.
Entrambi i progetti si basano sulle stesse fondamenta che ci hanno portato fin qui. NeMo, lo stack open di NVIDIA, ha accelerato la costruzione dei nostri primi modelli e sta guidando anche la costruzione dei prossimi. Come dicevamo all'inizio, costruire AI sovrana non significa costruirla da soli: significa farlo con partner il cui contributo lascia un segno reale e duraturo.
L’AI sovrana è un muscolo
Addestrare LLM è un mestiere: oltre a richiedere risorse computazionali ingenti, richiede di costruire competenza attraverso sperimentazione prolungata ed esperienza accumulata.
- Domyn Small: model card e technical report: https://arxiv.org/html/2607.20448v1
- Domyn Large: blog tecnico congiunto con NVIDIA: https://www.domyn.com/blog/domyn-large-the-journey-of-a-european-sovereign-ai-model-for-regulated-industries
- Colosseum 355B: blog tecnico congiunto con NVIDIA
- Evalita-LLM: arXiv 2502.02289
- Valutazione dei task enterprise: metodologia, codice e dataset su Hugging Face: https://huggingface.co/datasets/domyn/Enterprise-Task-Evaluation
- Domyn Swarm: LLM serving open source su HPC https://github.com/igeniusai/domyn-swarm


Domande frequenti