L’obiettivo di Domyn è mettere le organizzazioni nelle condizioni di avere il pieno controllo della propria AI. Per questo sviluppiamo modelli efficaci fin da subito, economici da utilizzare e che possono essere specializzati per svolgere task agentici.
Negli ultimi mesi abbiamo addestrato da zero un nuovo modello linguistico da 4 miliardi di parametri: Domyn Edge. Oggi lanciamo la prima fase di un rilascio progressivo che comprende non solo i pesi, ma anche i dataset, i checkpoint intermedi e il codice di addestramento. Ogni componente sarà disponibile con licenze aperte, in modo che la community possa verificare e riprodurre il nostro lavoro, ma anche usarlo come base per i propri sviluppi.
Domyn Edge è stato addestrato su 13.000 miliardi (13T) di token, interamente su infrastruttura pubblica europea. È progettato per task agentici su contesti lunghi: è stato addestrato fino a 1 milione di token, con un contesto operativo consigliato di 256k.
L’addestramento si è svolto su Leonardo, il supercomputer EuroHPC ospitato da CINECA. Rilasciando i checkpoint intermedi, le ricette di addestramento, gli strumenti e i dati che abbiamo utilizzato, vogliamo contribuire alla crescita dell’ecosistema europeo dell’AI e dimostrare che l’infrastruttura pubblica può sostenere lo sviluppo di modelli pensati per l’era agentica.
Un rilascio in più fasi
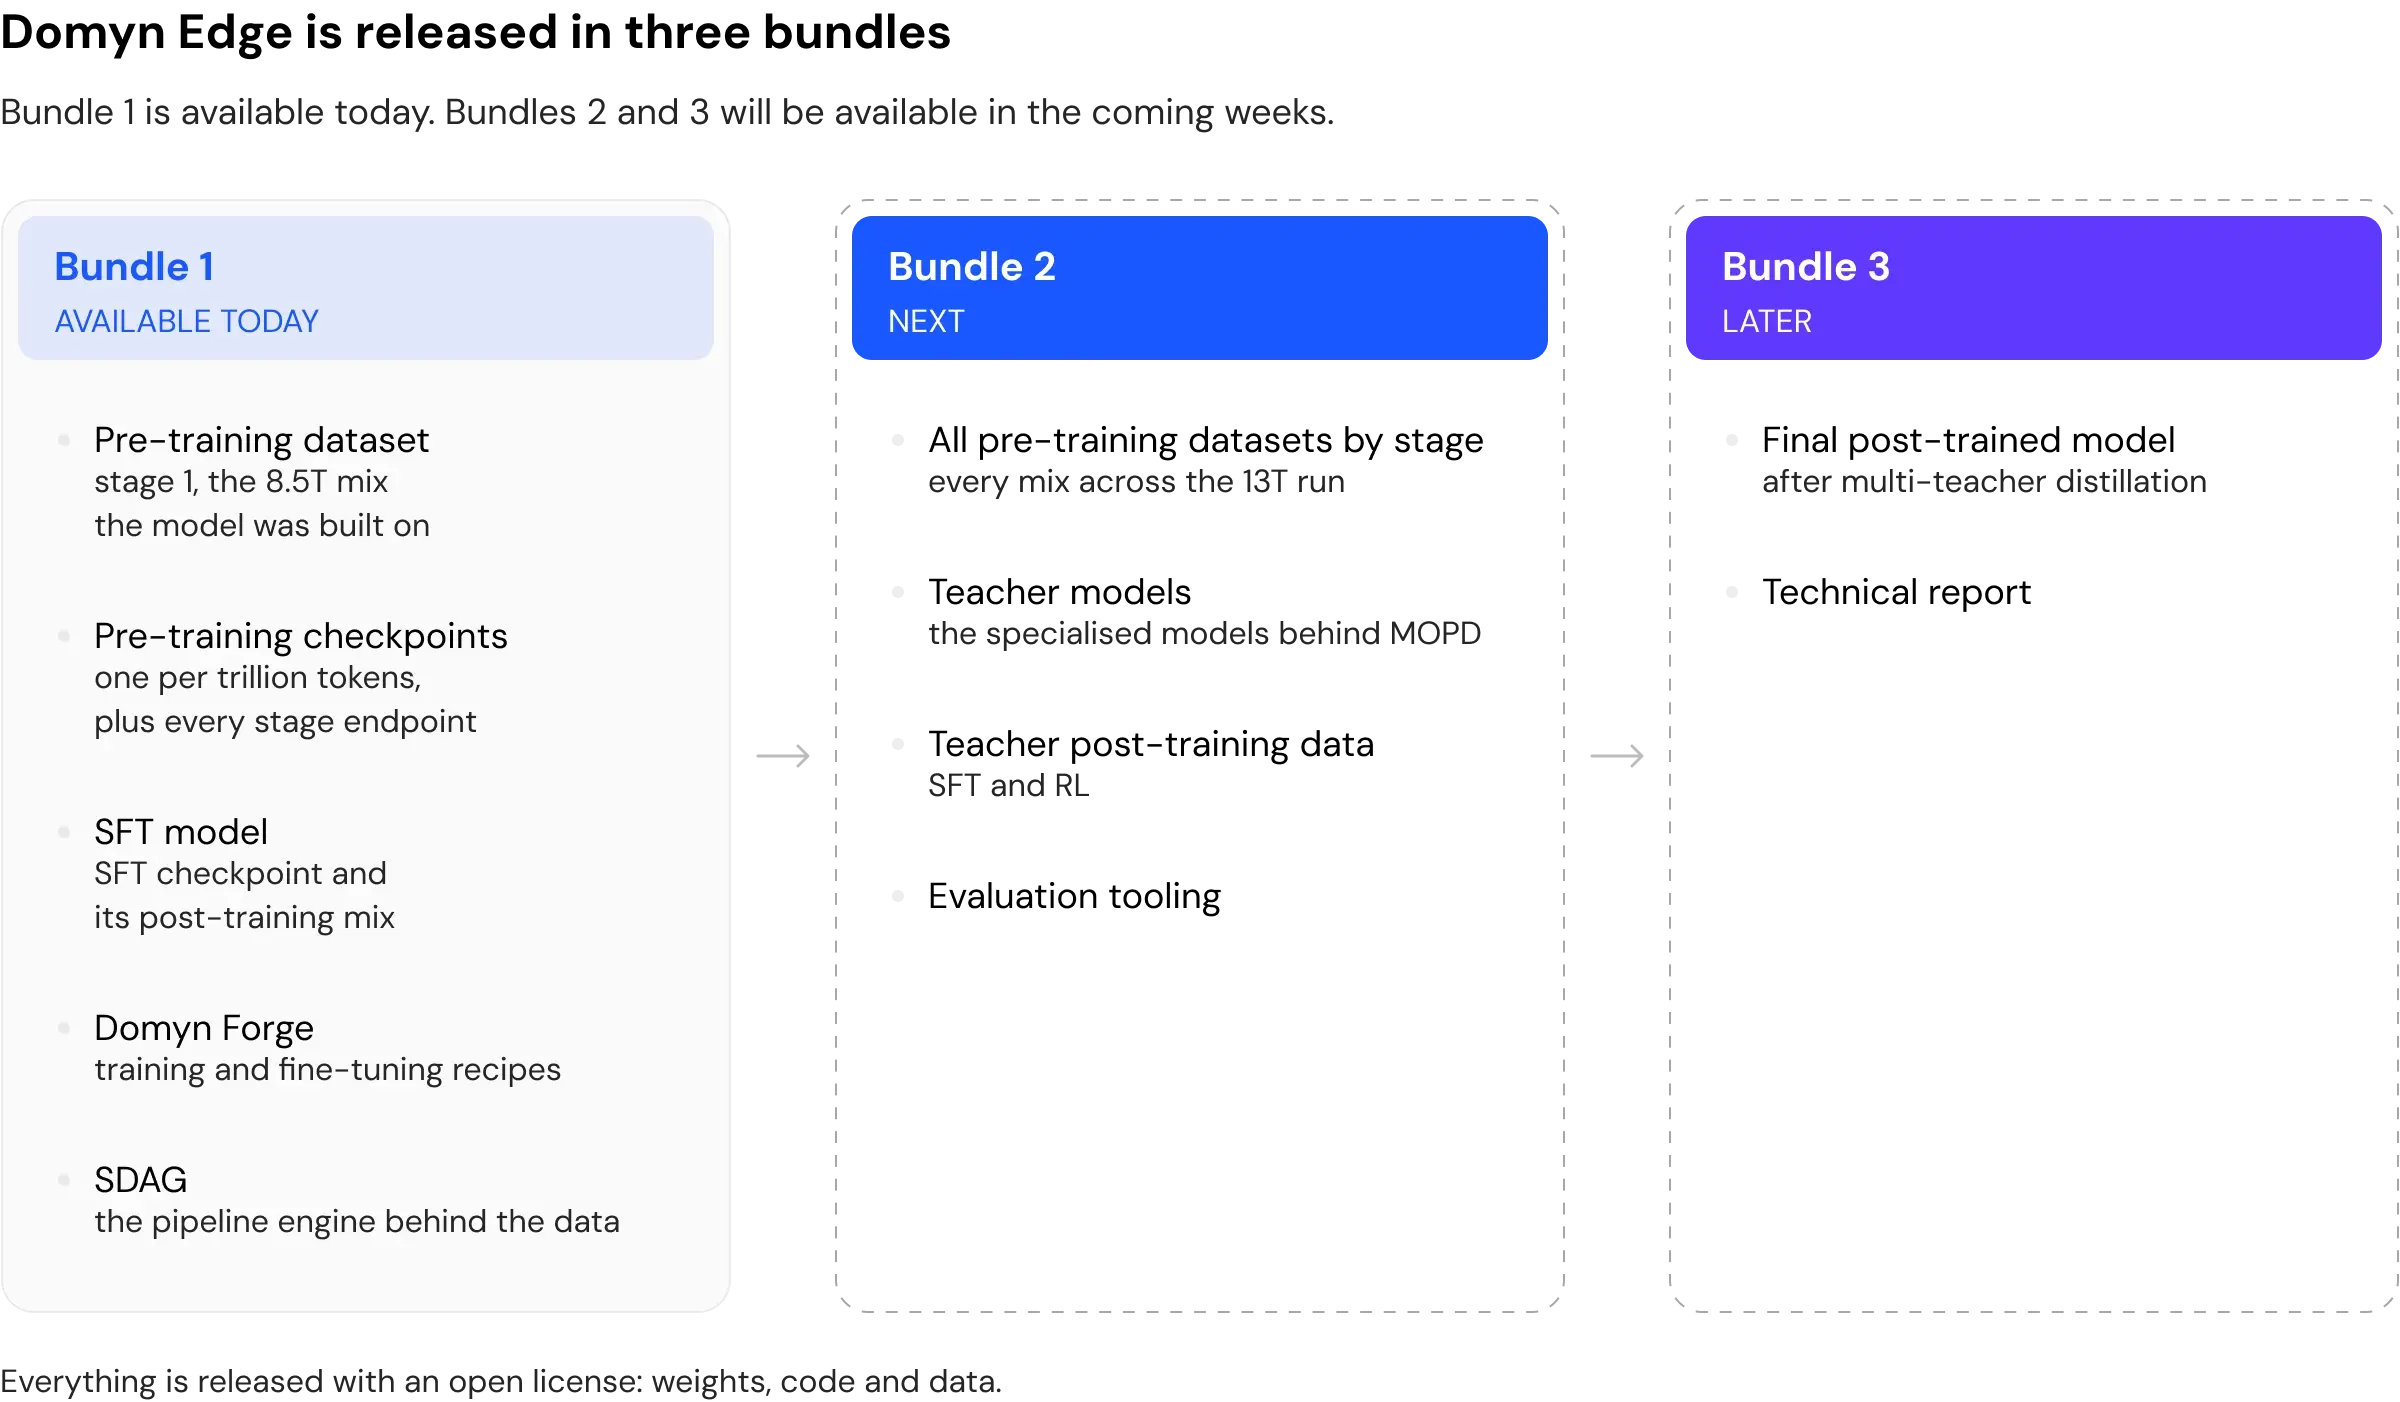
Domyn Edge viene rilasciato in più fasi. La prima comprende il modello base pre-addestrato, i relativi checkpoint intermedi, il checkpoint student e il codice di addestramento. Nelle prossime settimane renderemo disponibili il modello definitivo post addestramento, i dati e gli altri materiali di ricerca, come mostrato nella Figura 1.
Aperto per scelta, non per caso
Oggi la maggior parte dei modelli di piccole dimensioni è open weights: si possono eseguire, ma non è possibile sapere come sono stati costruiti, sottoporli ad audit o riprodurli. Questo rende difficile adattarli alle esigenze specifiche dei diversi settori. Abbiamo quindi sviluppato Domyn Edge per superare questo limite, con l’ambizione di realizzare il modello completamente aperto più performante della sua categoria.
Trasparenza totale su pesi, codice e dataset.
Rilasciando dataset, checkpoint intermedi e codice, rendiamo l’intero processo di addestramento ispezionabile, verificabile e riproducibile, oltre che estendibile in autonomia. Si tratta di una condizione essenziale per le organizzazioni regolamentate con cui Domyn lavora, che devono avere il pieno controllo dei propri modelli, e per i gruppi di ricerca che vogliono usarli come punto di partenza per nuovi sviluppi.
Addestrato su risorse di calcolo pubbliche.
Domyn Edge è stato addestrato su Leonardo con risorse assegnate nell’ambito del programma EuroHPC AI Factories: circa 2,3 milioni di ore GPU per il pre-training e circa 5 milioni sull’intero progetto, dagli esperimenti di ablazione alla generazione dei dati, fino al post-training e alla valutazione.
Per sviluppare Domyn Edge abbiamo dovuto costruire anche nuovi strumenti per eseguire carichi di lavoro legati agli LLM su cluster HPC condivisi, e li stiamo rilasciando progressivamente insieme al modello. Due sono già disponibili: Domyn Swarm, che gestisce l’inferenza su larga scala in ambienti SLURM per generare dati sintetici e valutare i modelli, e SDAG, che consente di definire ed eseguire pipeline come DAG, sempre su SLURM, con caching dei task. Da oggi si aggiunge Domyn Forge, il codice con cui abbiamo addestrato Domyn Edge, mentre gli strumenti per l’elaborazione dei dati e la valutazione arriveranno nelle prossime fasi.
Abbastanza compatto da essere davvero vostro.
Con 4 miliardi di parametri, Domyn Edge gira su una singola GPU, on-premises o in ambienti air-gapped, e può essere adattato ai vostri dati con il fine-tuning o altre forme di post-training, a costi contenuti.
Architettura e pre-training
Domyn Edge è un transformer denso a 36 strati con grouped query attention. Gli strati di attenzione si alternano secondo uno schema fisso: tre strati con attenzione a finestra scorrevole (sliding window) per ogni strato ad attenzione completa, con i rotary embedding applicati solo ai primi. Gli strati ad attenzione completa hanno inoltre teste di dimensione maggiore, così che la capacità del modello si concentri dove l’attenzione ha il raggio più ampio. Gli iperparametri completi sono riportati nella model card.
Il tokenizer estende il vocabolario BPE di GPT-4 con token dedicati alle cinque lingue target principali: inglese, italiano, spagnolo, francese e tedesco. L’obiettivo è rendere più efficiente la tokenizzazione nelle principali lingue europee, mantenendo prestazioni elevate su inglese e codice.
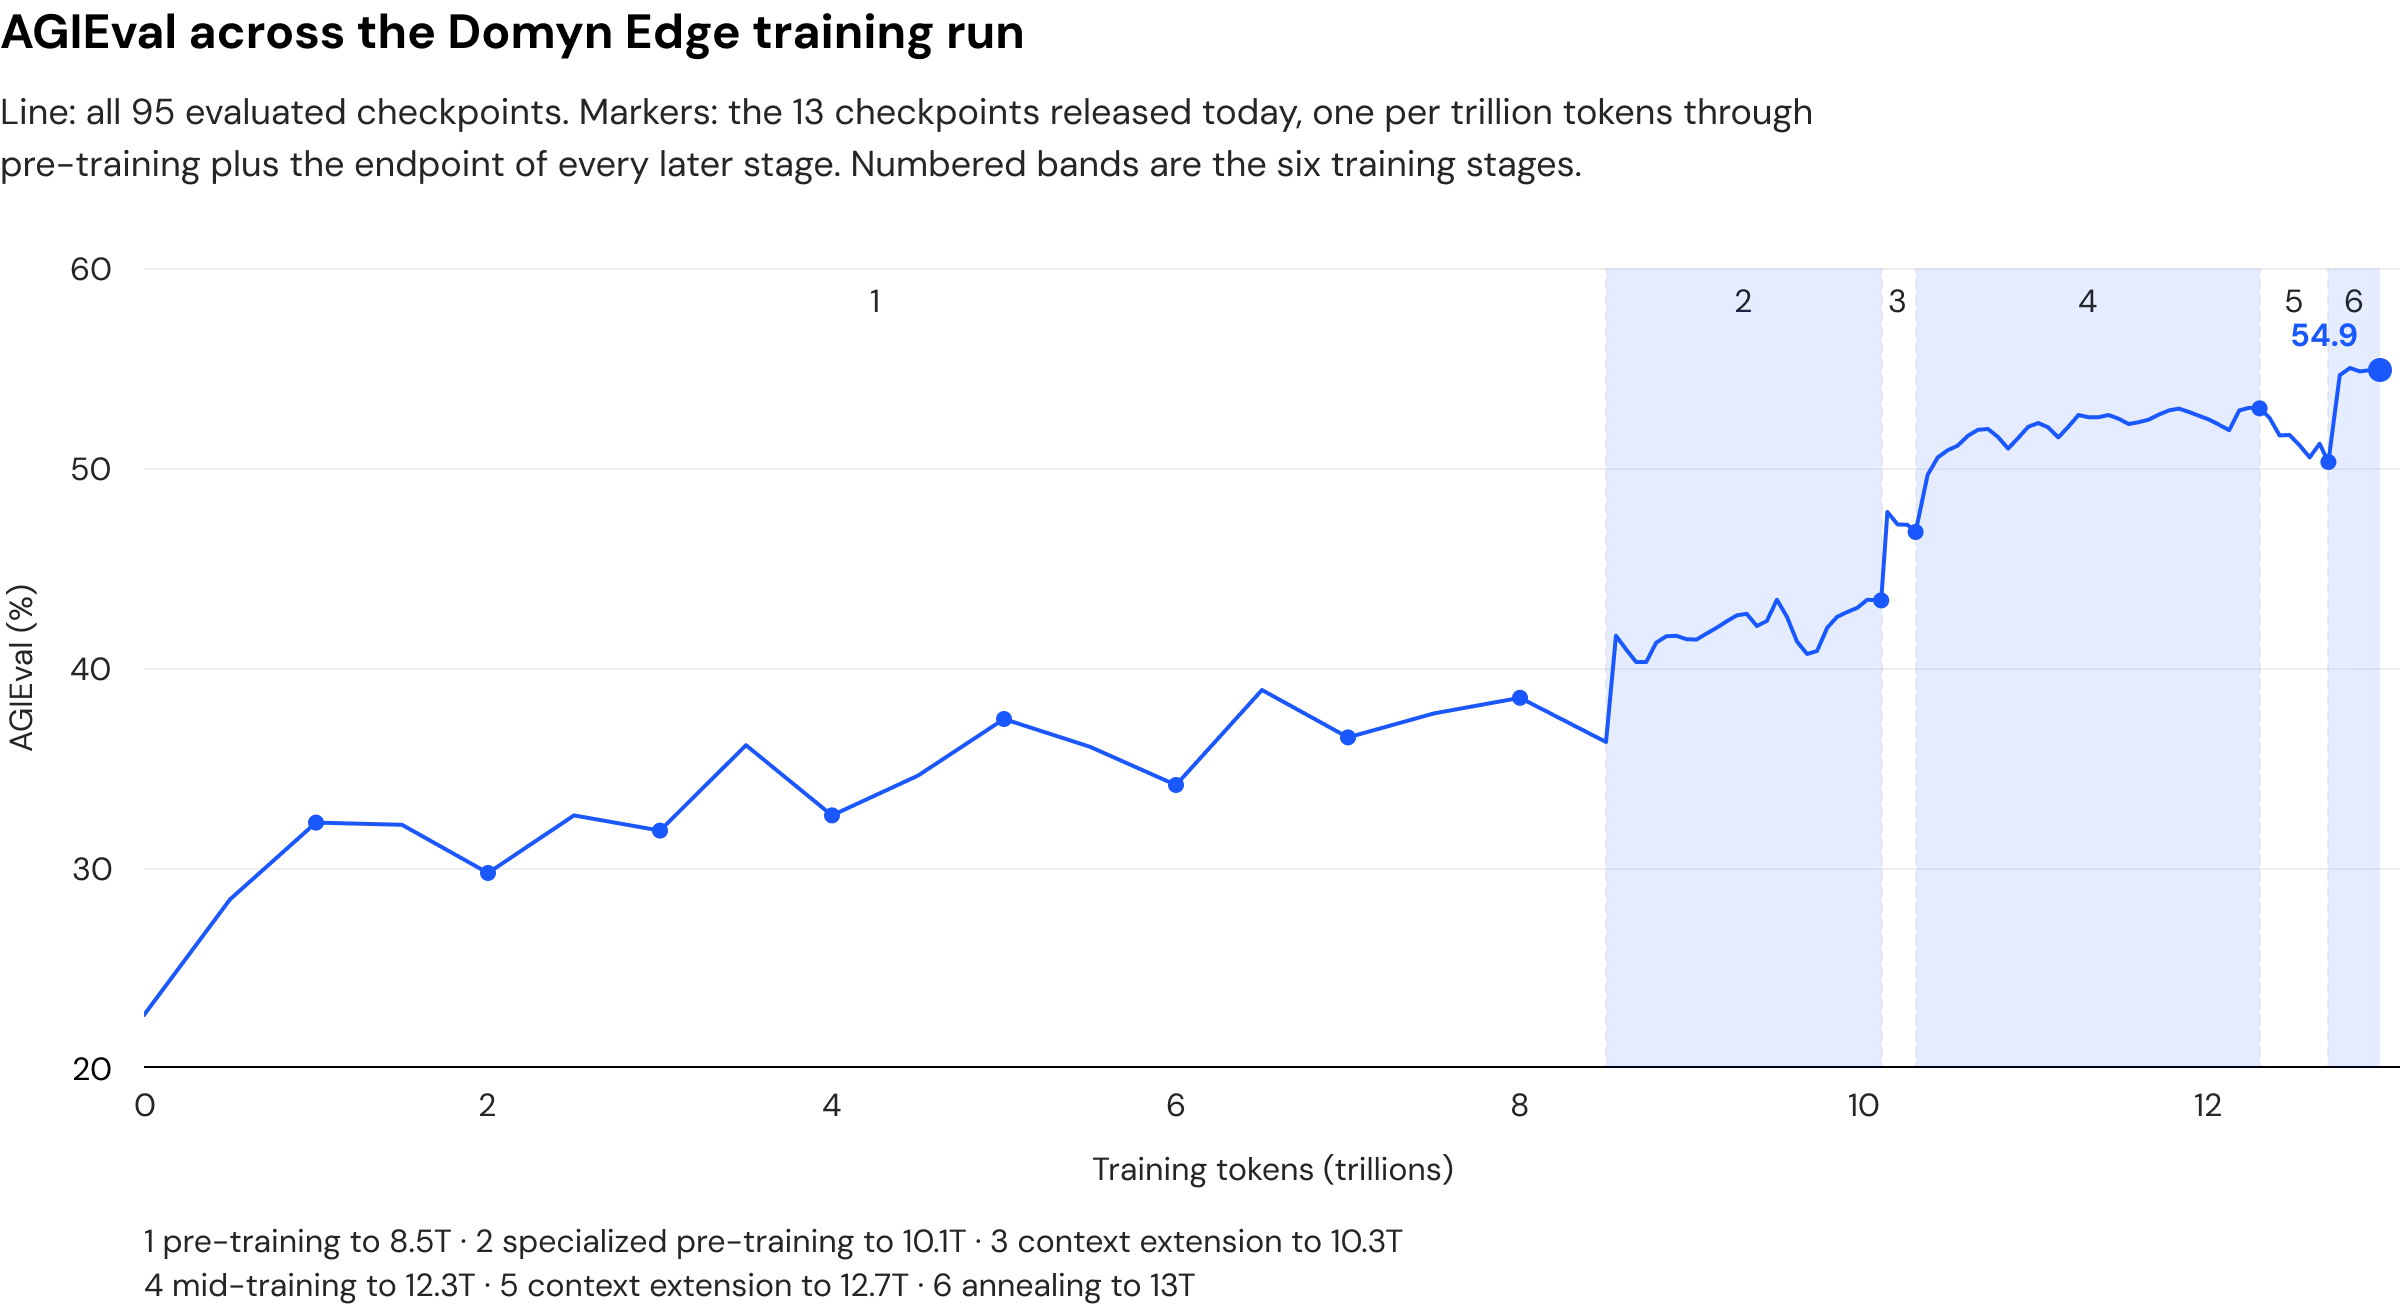
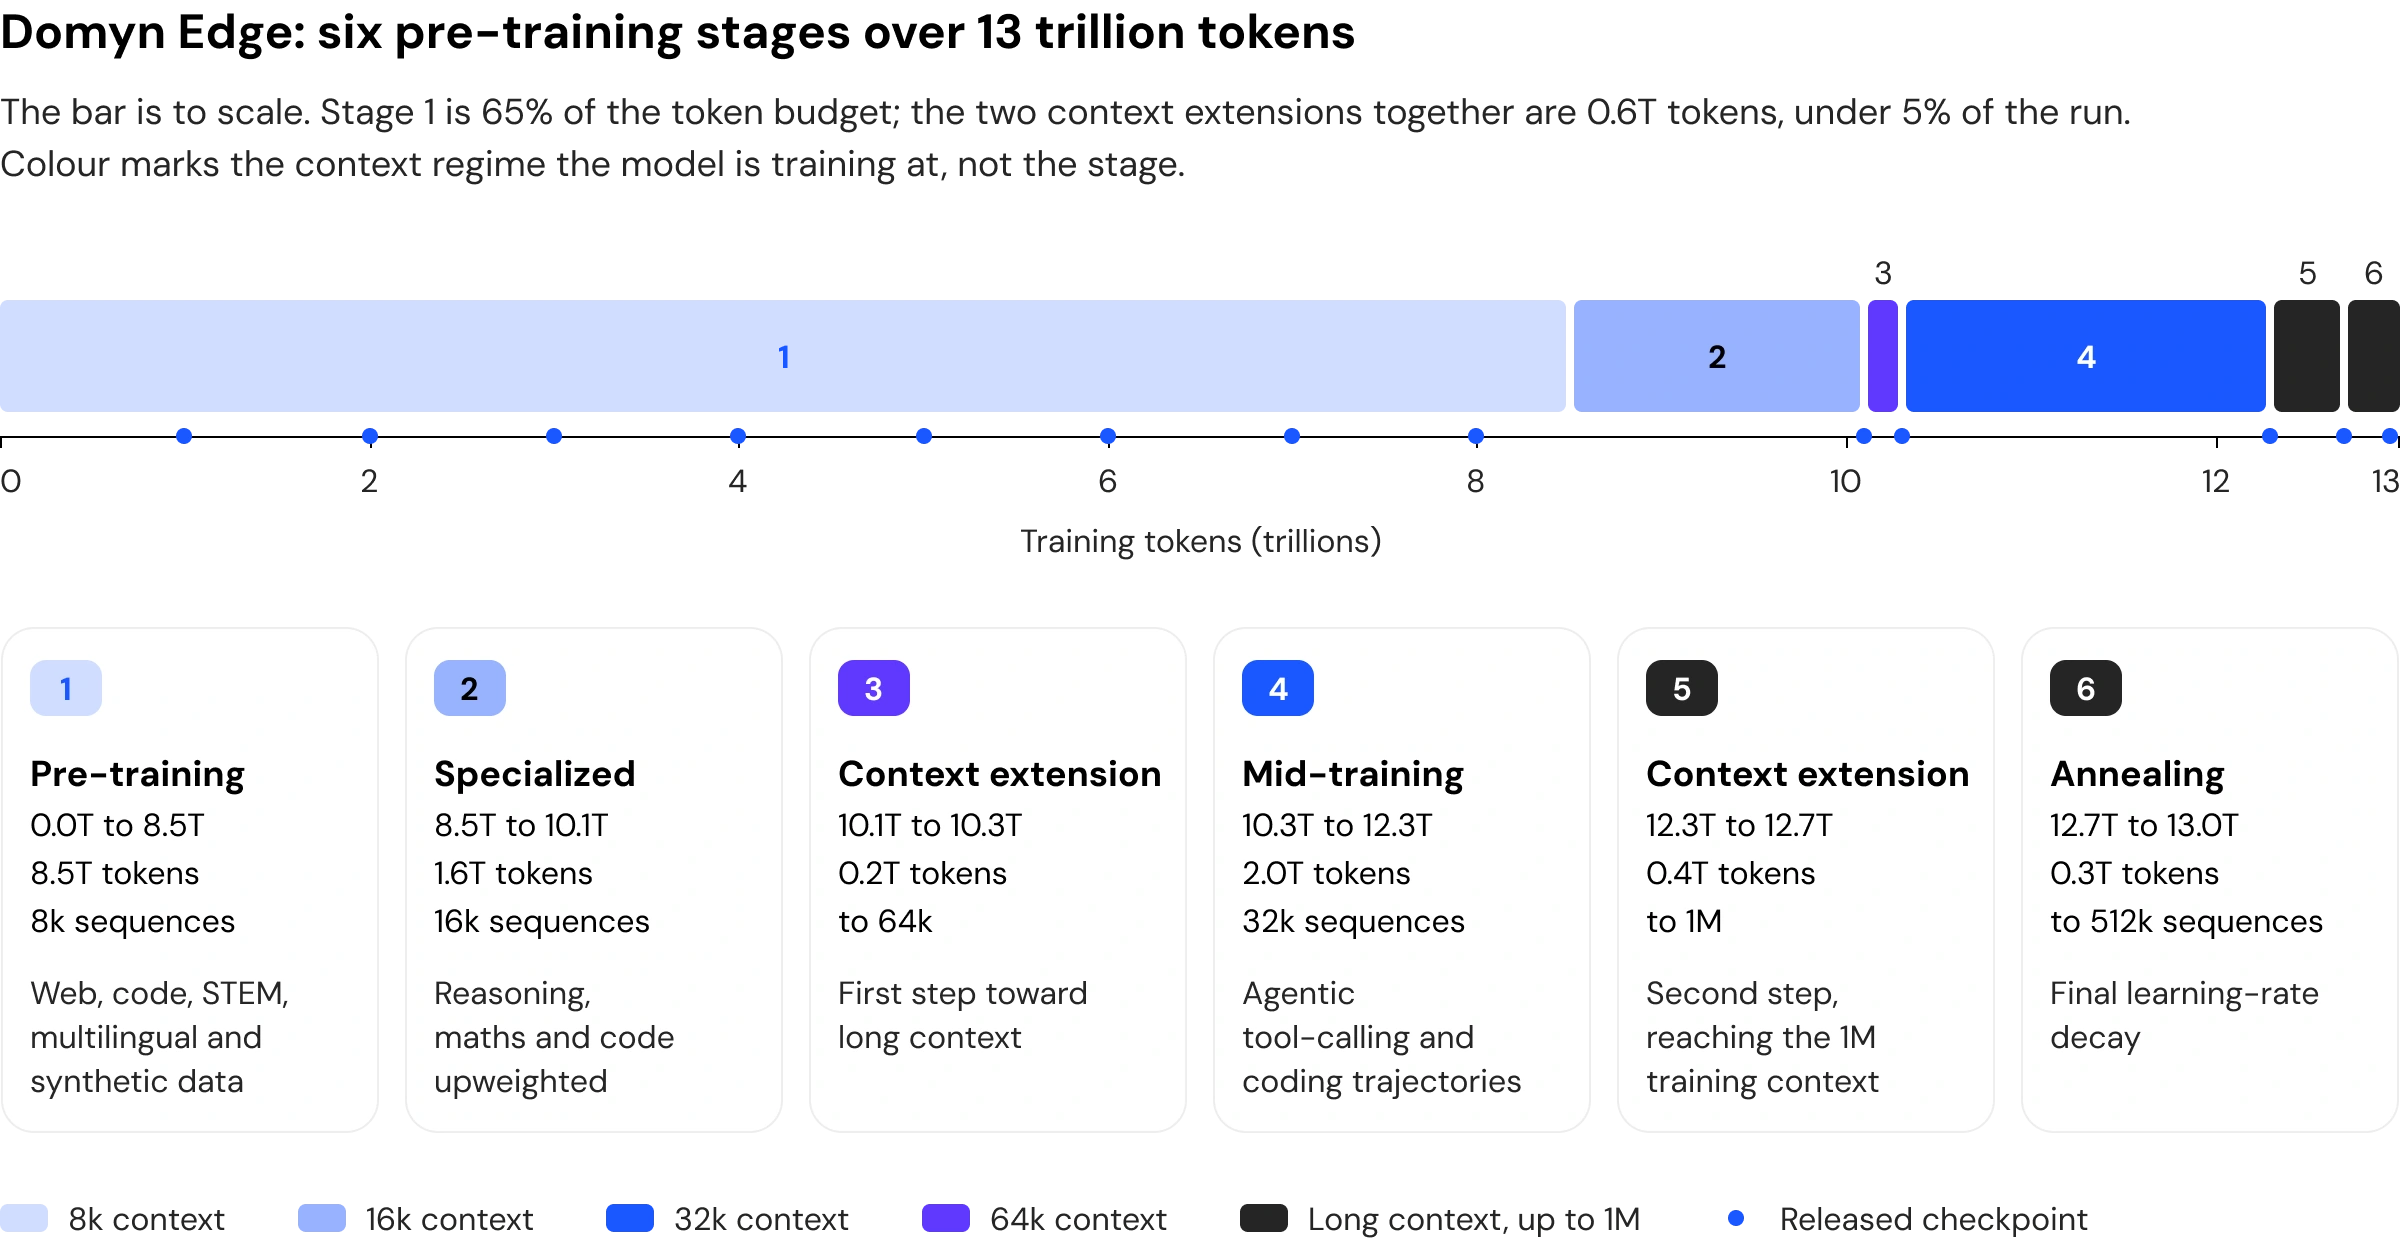
Come mostrato sopra, l’addestramento si è articolato in sei stadi, per un totale di 13T token:
- Pre-training fino a 8,5T token, su un mix di dati web, codice, STEM, multilingue e sintetici, con sequenze da 8k.
- Pre-training specializzato fino a 10,1T, con un peso maggiore assegnato a dati di alta qualità su ragionamento, matematica e codice.
- Estensione del contesto fino a 10,3T, primo passo verso il contesto lungo.
- Mid-training fino a 12,3T, su sequenze da 32k, con l’aggiunta di traiettorie agentiche di tool calling e coding.
- Seconda estensione del contesto fino a 12,7T, con un contesto di addestramento di 1M token.
- Annealing fino a 13T, con la riduzione finale del learning rate.
Rilasciamo un checkpoint ogni 1T token durante il pre-training, oltre al punto finale di ciascuno stadio successivo, così da poter seguire lo sviluppo di ciascuna capacità nel corso dell’addestramento.
L’addestramento è stato eseguito su 128 nodi da 4 GPU NVIDIA A100 64GB, per un totale di 512 GPU, con TorchTitan e una strategia ibrida: FSDP all’interno dei nodi e DDP tra i nodi.
Il codice di addestramento, rilasciato come Domyn Forge, utilizza TorchTitan come dipendenza. La prima fase include gli script e le ricette di pre-training. Chi vuole proseguire il pre-training di Domyn Edge sui propri dati può quindi farlo in modo riproducibile, con lo stesso codice che abbiamo utilizzato noi.
Con l’ultima fase di rilascio pubblicheremo un report tecnico completo, che illustrerà la provenienza dei dati, il mix dei dataset e i pesi di campionamento di ogni stadio, gli studi di ablazione su architettura e tokenizer, oltre alle principali lezioni apprese. Nel frattempo, come riferimento principale, vi rimandiamo alle model card su Hugging Face, che aggiorneremo a ogni nuovo rilascio.
Il modello SFT e il protocollo di post-training
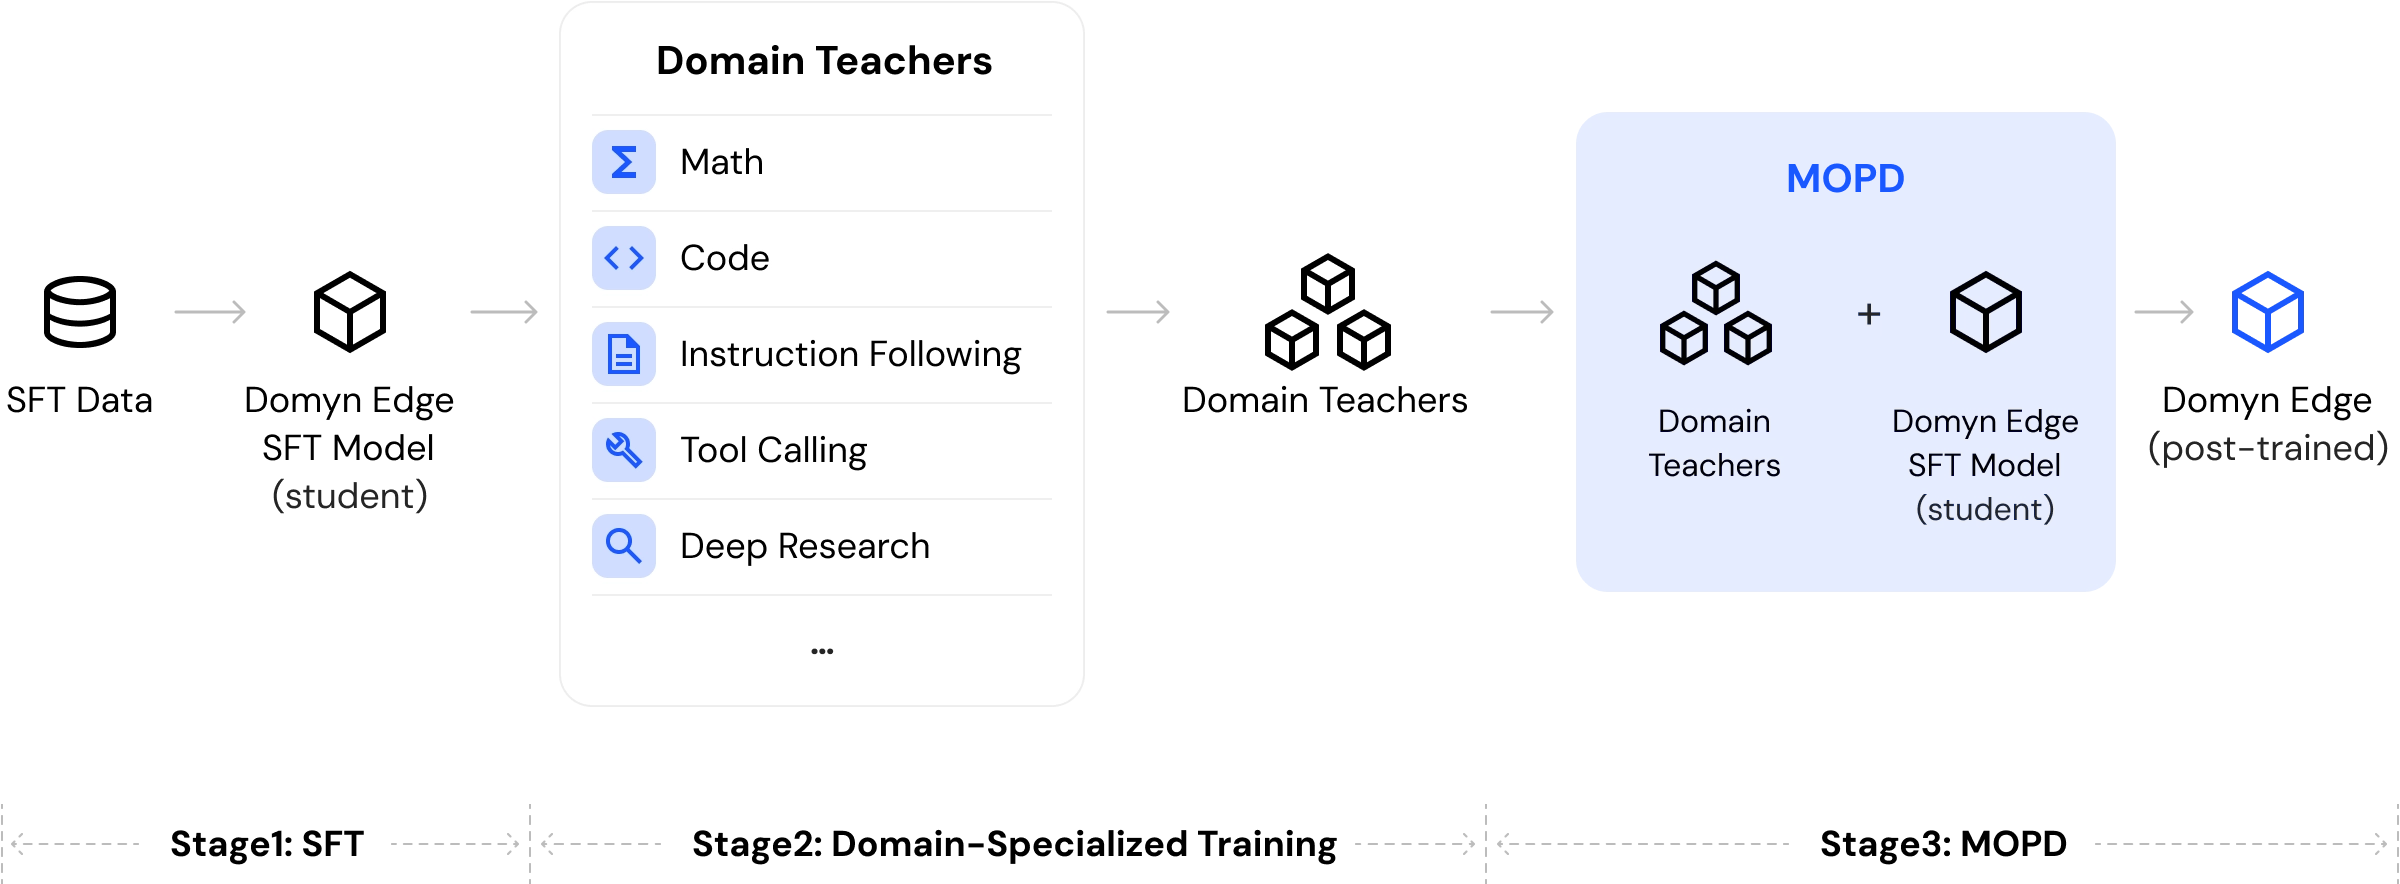
La prima fase comprende anche il checkpoint SFT, ovvero il modello base dopo un ampio ciclo di supervised fine-tuning su matematica, codice, tool calling e instruction following.
Chiamiamo questo checkpoint modello student perché, nella fase successiva del nostro protocollo di post-training, apprenderà dai modelli teacher attraverso la Multi-Teacher On-Policy Distillation (MOPD)[1]. Nello specifico, addestriamo con SFT e GRPO diversi modelli teacher, ciascuno specializzato in un ambito specifico, per poi trasferirne le competenze a un unico modello student tramite distillazione. Il checkpoint rilasciato oggi è il punto di partenza di questo processo, non il suo risultato finale. Non è stato quindi sottoposto ad alcun post-training basato su reinforcement learning.
Già nella sua forma attuale, il modello offre prestazioni solide: per questo lo rendiamo disponibile fin dalla prima fase, così che le organizzazioni possano provarlo e iniziare a costruire le proprie applicazioni. Nella seconda fase rilasceremo tutti i modelli teacher, ciascuno specializzato nel proprio ambito, e nella terza il modello student definitivo. Siamo convinti che saranno una risorsa preziosa per la community di ricerca e per chi sviluppa soluzioni di AI.
Benchmarks
Modello base
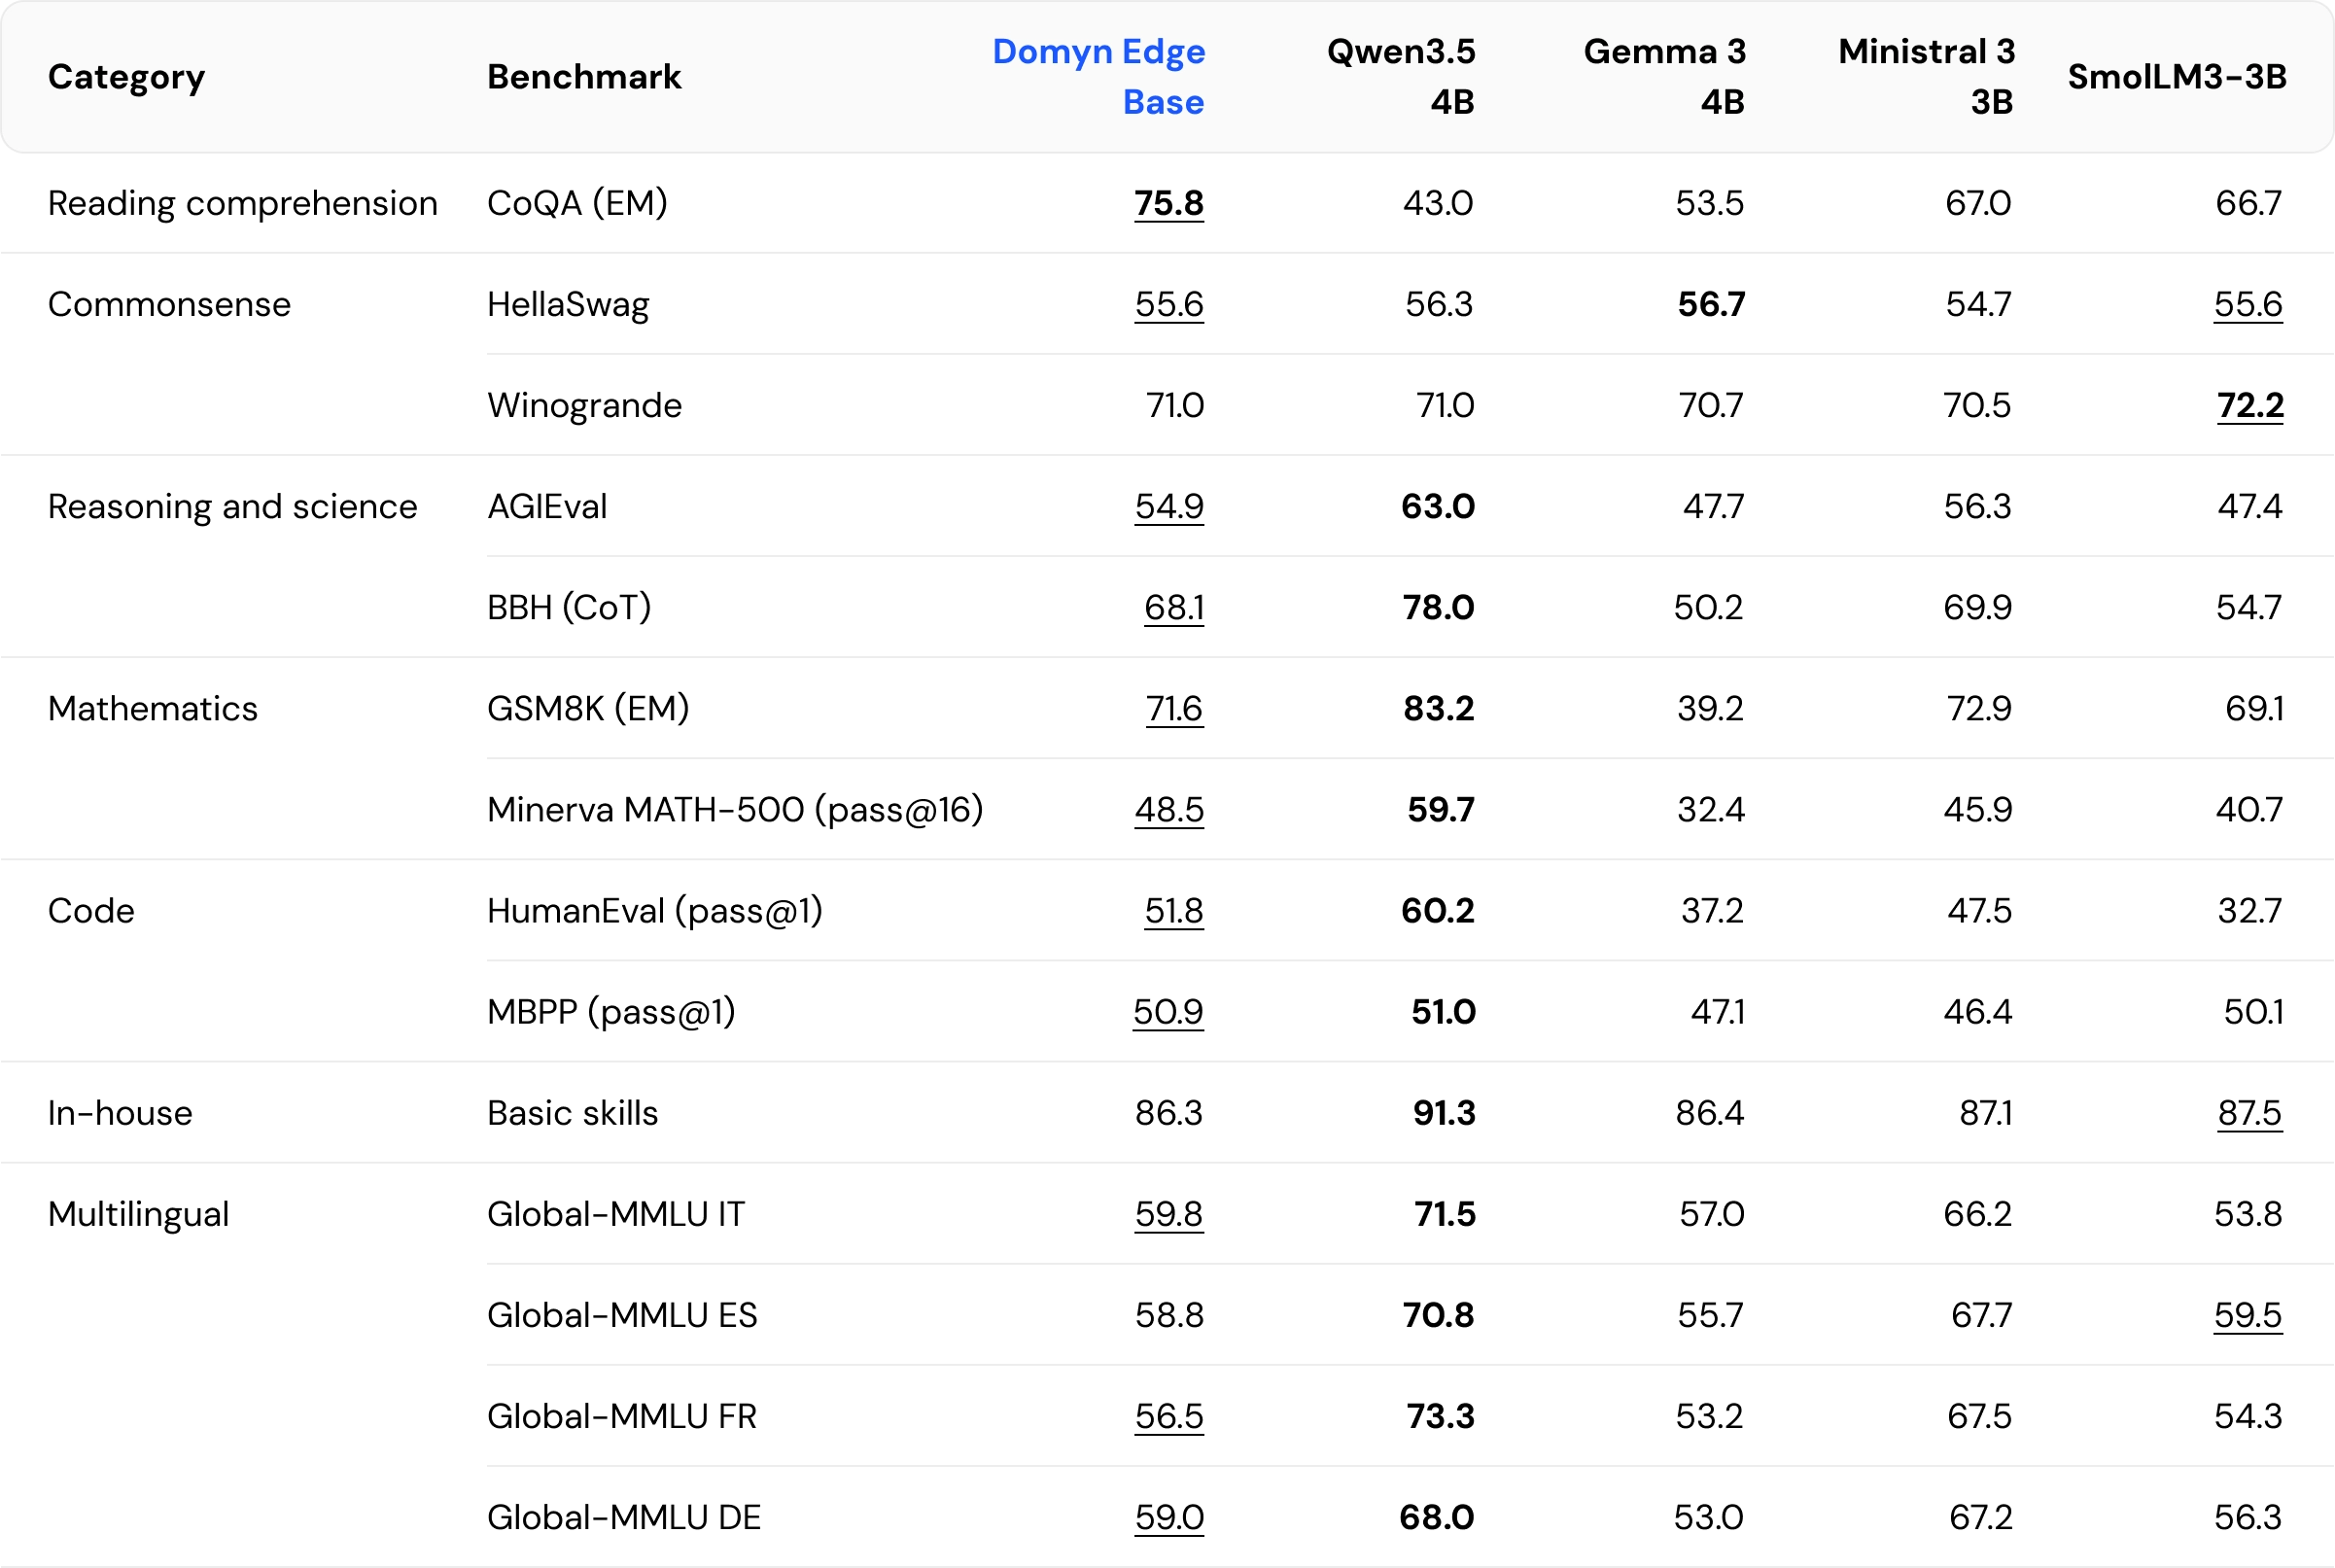
Al termine del pre-training, Domyn Edge è il modello completamente aperto più performante della sua categoria. Per i modelli sotto i 4B di parametri (Domyn Edge ne conta poco meno di 4 miliardi), il confronto di riferimento è con SmolLM3-3B, l’unico modello di queste dimensioni rilasciato insieme ai dataset e alle ricette di addestramento. Il modello base lo supera su dieci dei quattordici benchmark riportati di seguito, è alla pari su uno ed è dietro su Winogrande, basic skills e Global-MMLU in spagnolo.
Il risultato regge anche nel confronto con i modelli open weights. Domyn Edge supera Gemma 3 4B su otto benchmark su dieci e si mantiene in equilibrio con Ministral 3 3B, sei benchmark a quattro. Qwen3.5 4B resta il riferimento della categoria ed è in vantaggio su diversi benchmark, ma Domyn Edge Base riduce il divario su Winogrande e MBPP.
Nota: in grassetto il punteggio migliore in assoluto; sottolineato il miglior modello completamente open source. Tutti i modelli sono base model, prima del post-training.
Per valutare le prestazioni su contesti lunghi, riportiamo i risultati del checkpoint finale sul benchmark RULER per lunghezze di contesto crescenti, confrontandoli con quelli di Qwen3.5 4B.
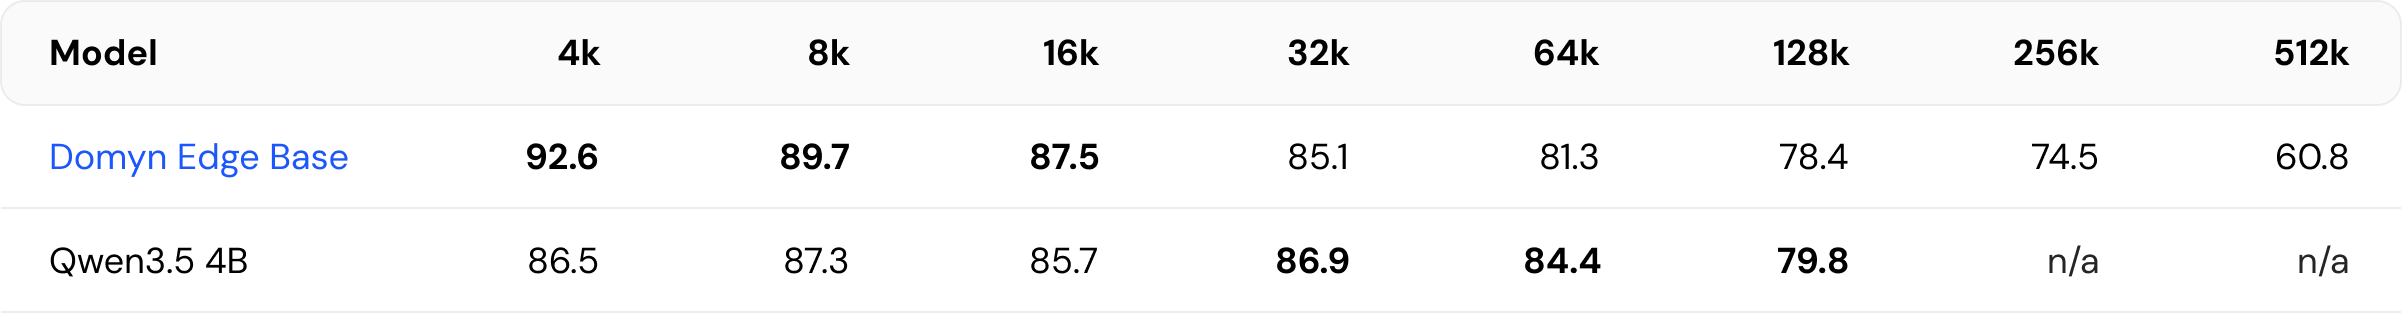
In origine, la lunghezza di contesto utilizzabile era limitata a 8k token. Un’estensione del contesto in due fasi, su 0,5T token, ha portato le prestazioni su contesti lunghi a un livello competitivo con Qwen3.5 4B. Un annealing mirato ha poi consentito di raggiungere i punteggi più alti su tutte le lunghezze di contesto fino a 256k token.
Modello SFT (student pre-RL)
Di seguito riportiamo i risultati del modello student prima del reinforcement learning. Poiché questo checkpoint non ha ancora ricevuto l’allineamento del post-training, le prestazioni su codice e matematica sono valutate con le metriche pass@4 e pass@16.
Nota: in grassetto il punteggio migliore in assoluto; sottolineato il miglior modello completamente open source. I benchmark confrontano il modello student, non ancora allineato, con baseline che hanno completato il post-training: il nostro modello post-addestrato definitivo sarà rilasciato nella fase 3.
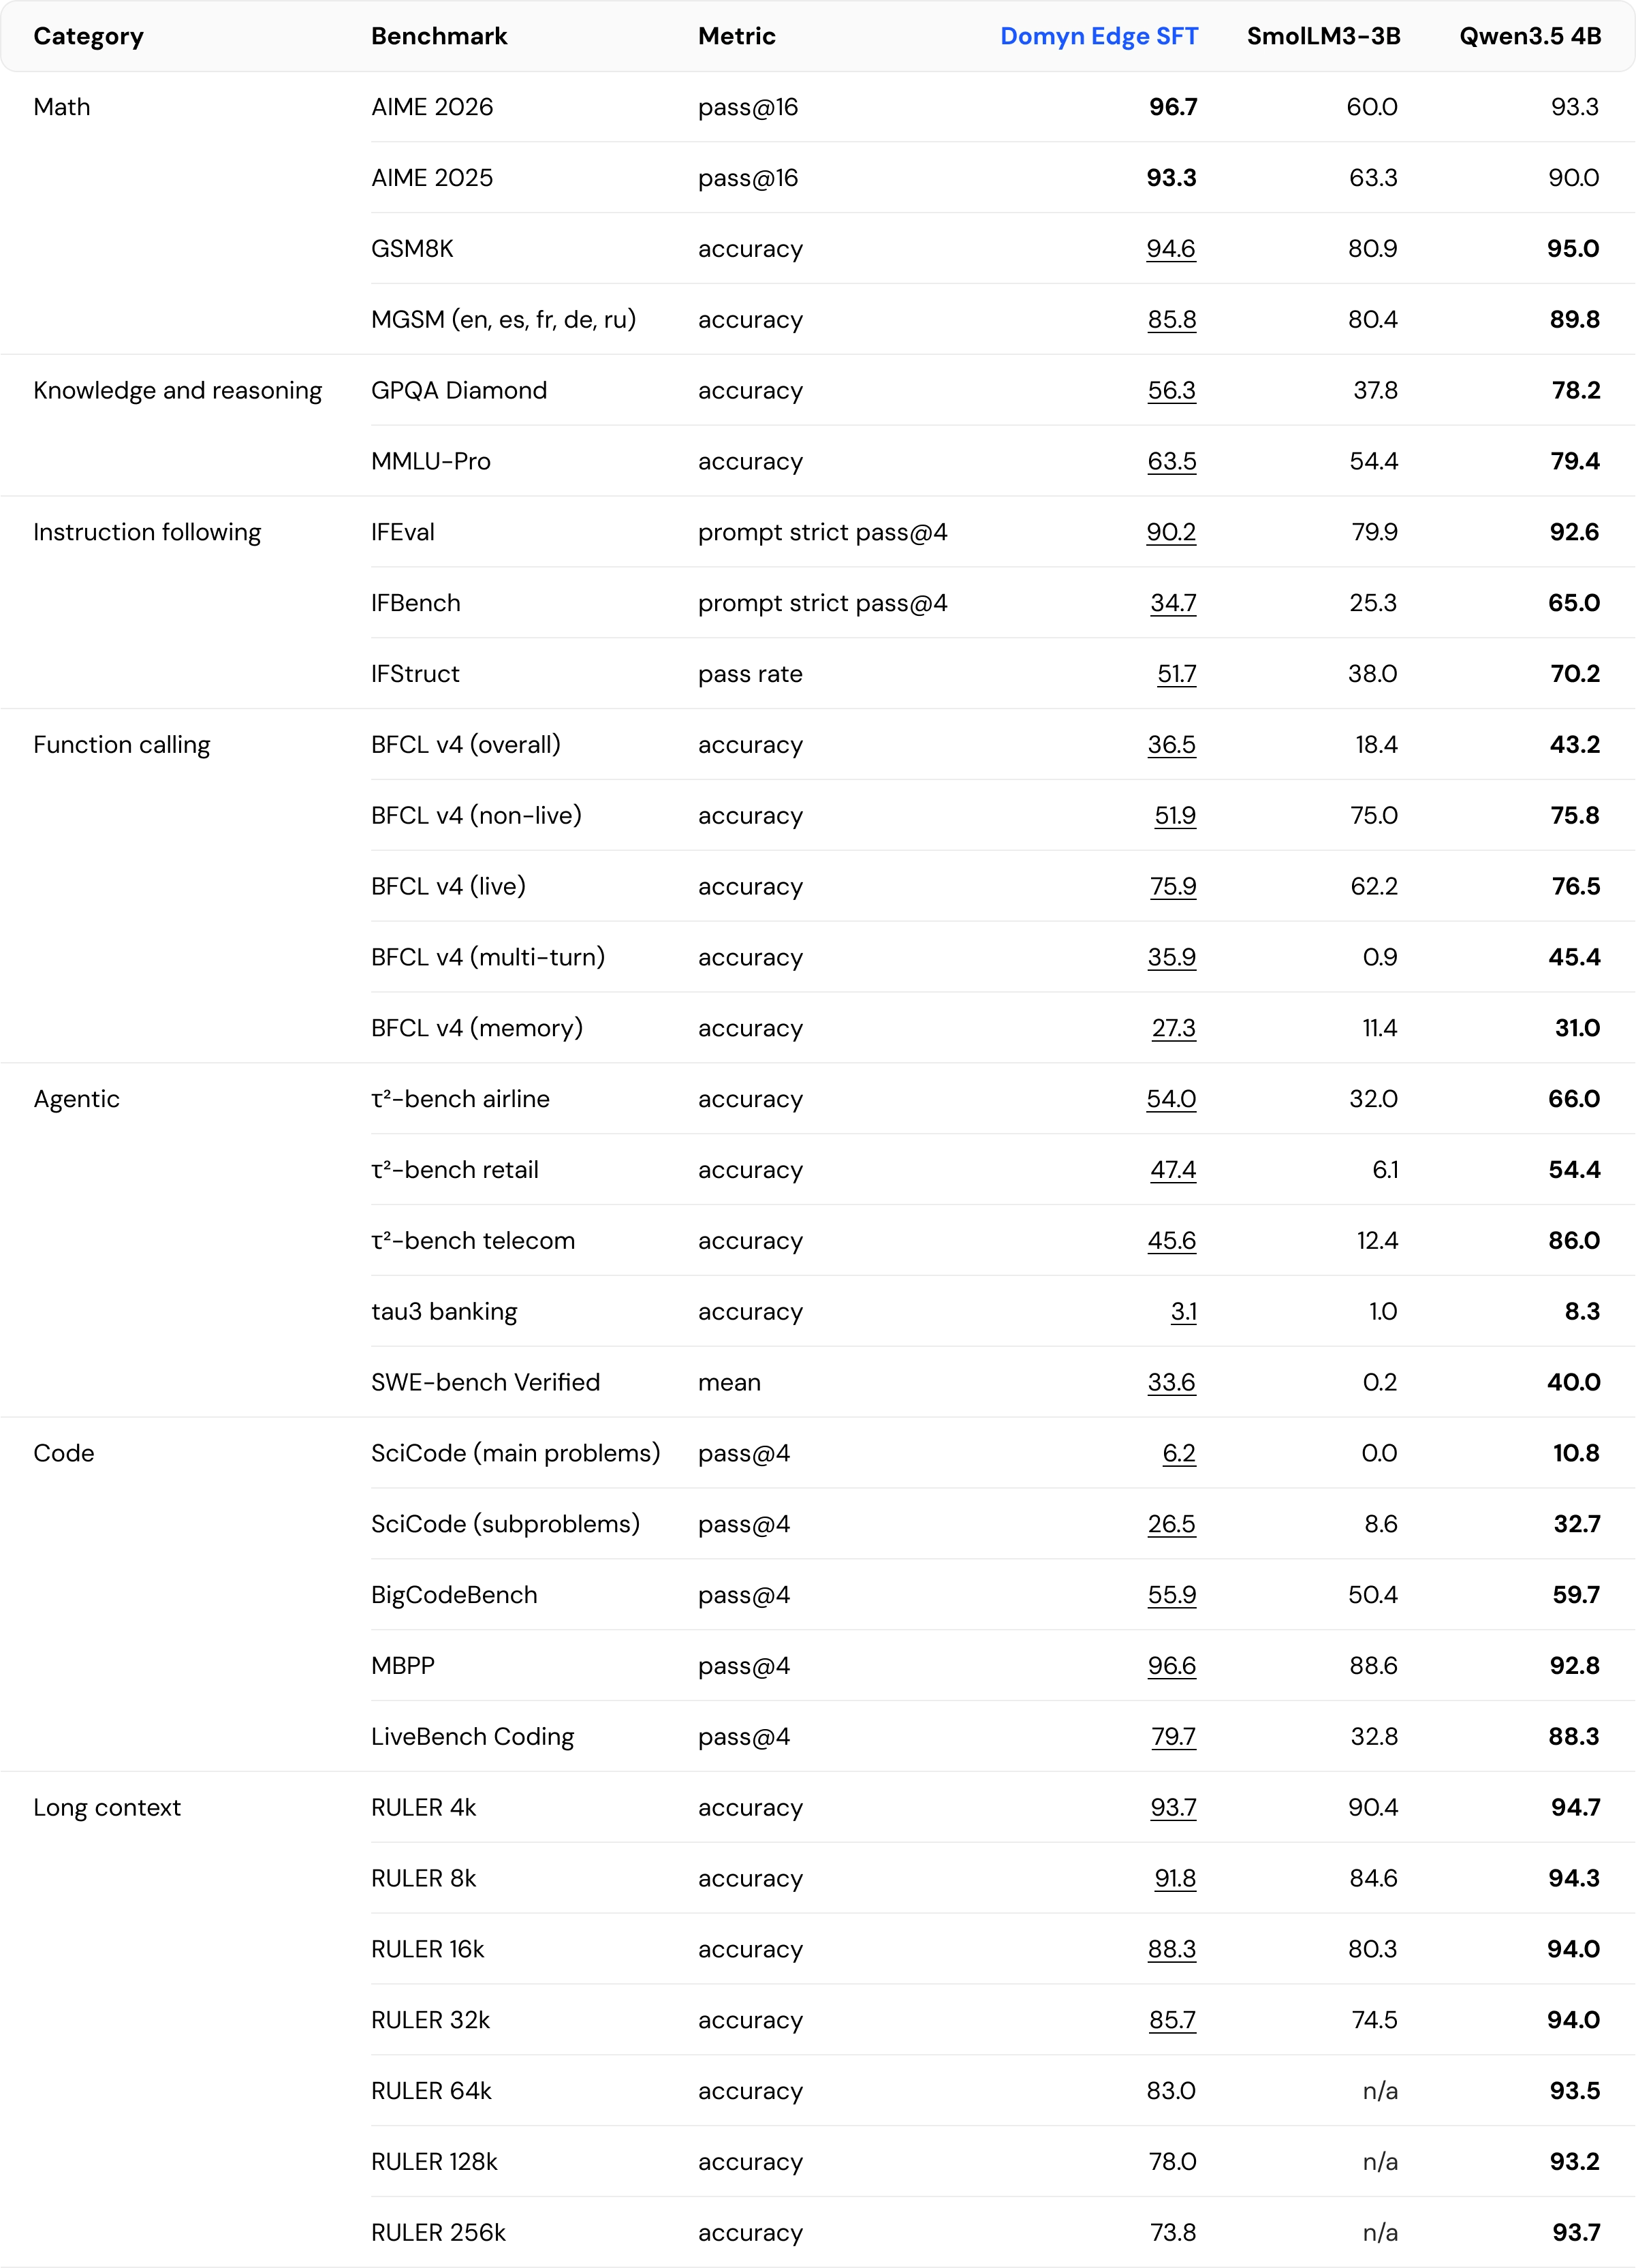
Rispetto a SmolLM3-3B, l’unico altro modello completamente aperto di questa categoria, il modello student registra miglioramenti sostanziali ed è in vantaggio su 27 dei 28 benchmark in comune.
Nel confronto con Qwen3.5 4B, che ha completato l’intero post-training, questo checkpoint iniziale ne eguaglia o supera già le prestazioni sui principali task quantitativi e di codice (ad esempio AIME 2025/2026 pass@16 e MBPP pass@4). Restano i divari attesi sui benchmark ad alta intensità di conoscenza (MMLU-Pro, GPQA Diamond) e sui benchmark agentici a tentativo singolo (IFBench, τ²-bench/tau3). I risultati delineano comunque una base solida, e prevediamo di colmare il divario con il rilascio del modello definitivo.
Mettetelo alla prova
Domyn Edge è un modello molto competitivo nella sua categoria, che potete adattare, controllare e distribuire in piena autonomia. Compatto e performante, si presta al fine-tuning personalizzato, all’esecuzione privata on-premises e al deployment in ambienti regolamentati che richiedono la conformità all’AI Act europeo. Grazie al suo design completamente aperto, offre a chi fa ricerca un punto di osservazione privilegiato su come si formano le capacità di un modello durante l’addestramento.
Non serve attendere il rilascio completo per iniziare: la prima fase è disponibile da oggi. Potete partire dal modello base, fare il fork di un checkpoint intermedio, avviare il fine-tuning del checkpoint SFT o semplicemente usarlo così com’è. Con la seconda e la terza fase avrete a disposizione l’intera pipeline (dataset, modelli teacher e versione definitiva post-addestrata) per verificarla, estenderla o ricostruirla da zero. Siamo curiosi di vedere cosa costruirà la community con Domyn Edge e, ancora di più, di sentire cosa scoprirete usandolo.
Ringraziamenti
Domyn Edge è stato addestrato su Leonardo, ospitato da CINECA, con risorse di calcolo assegnate attraverso il programma EuroHPC AI Factories. Ringraziamo CINECA e il team di Leonardo per il supporto lungo tutto l’addestramento.
Risorse
- Modello base: domyn/Domyn-Edge-Base
- Dataset di pre-training: domyn/Domyn-Edge-Pretraining-Mix-8.4T
- Checkpoint di pre-training: domyn/Domyn-Edge-Base-checkpoints
- Modello student: domyn/Domyn-Edge-SFT
- Codice di addestramento: Domyn Forge su GitHub
- Strumenti HPC: Domyn Swarm e SDAG su GitHub (domyn-ai)
- Collezione: Domyn Edge su Hugging Face
Riferimenti bibliografici
[1] Ma, W., et al. (2026). MOPD: Multi-Teacher On-Policy Distillation for Capability Integration. arXiv:2606.30406.


Domande frequenti