Come può un modello da 4 miliardi di parametri eccellere in cinque ambiti diversi senza sacrificarne nessuno? La chiave è non chiedergli di imparare tutto in una volta. Prima si addestrano i cinque specialisti, poi si distillano le loro competenze in un unico student. È così che nasce Domyn Edge.
Il 20 ottobre abbiamo rilasciato il primo bundle di Domyn Edge, un modello linguistico da 4 miliardi di parametri addestrato da zero su 13 trilioni di token, interamente su infrastruttura pubblica europea. L’addestramento si è svolto su Leonardo, il supercomputer EuroHPC ospitato da CINECA. Il modello è progettato per attività agentiche su contesti lunghi: è stato addestrato fino a 1 milione di token, con un contesto operativo raccomandato di 256k.
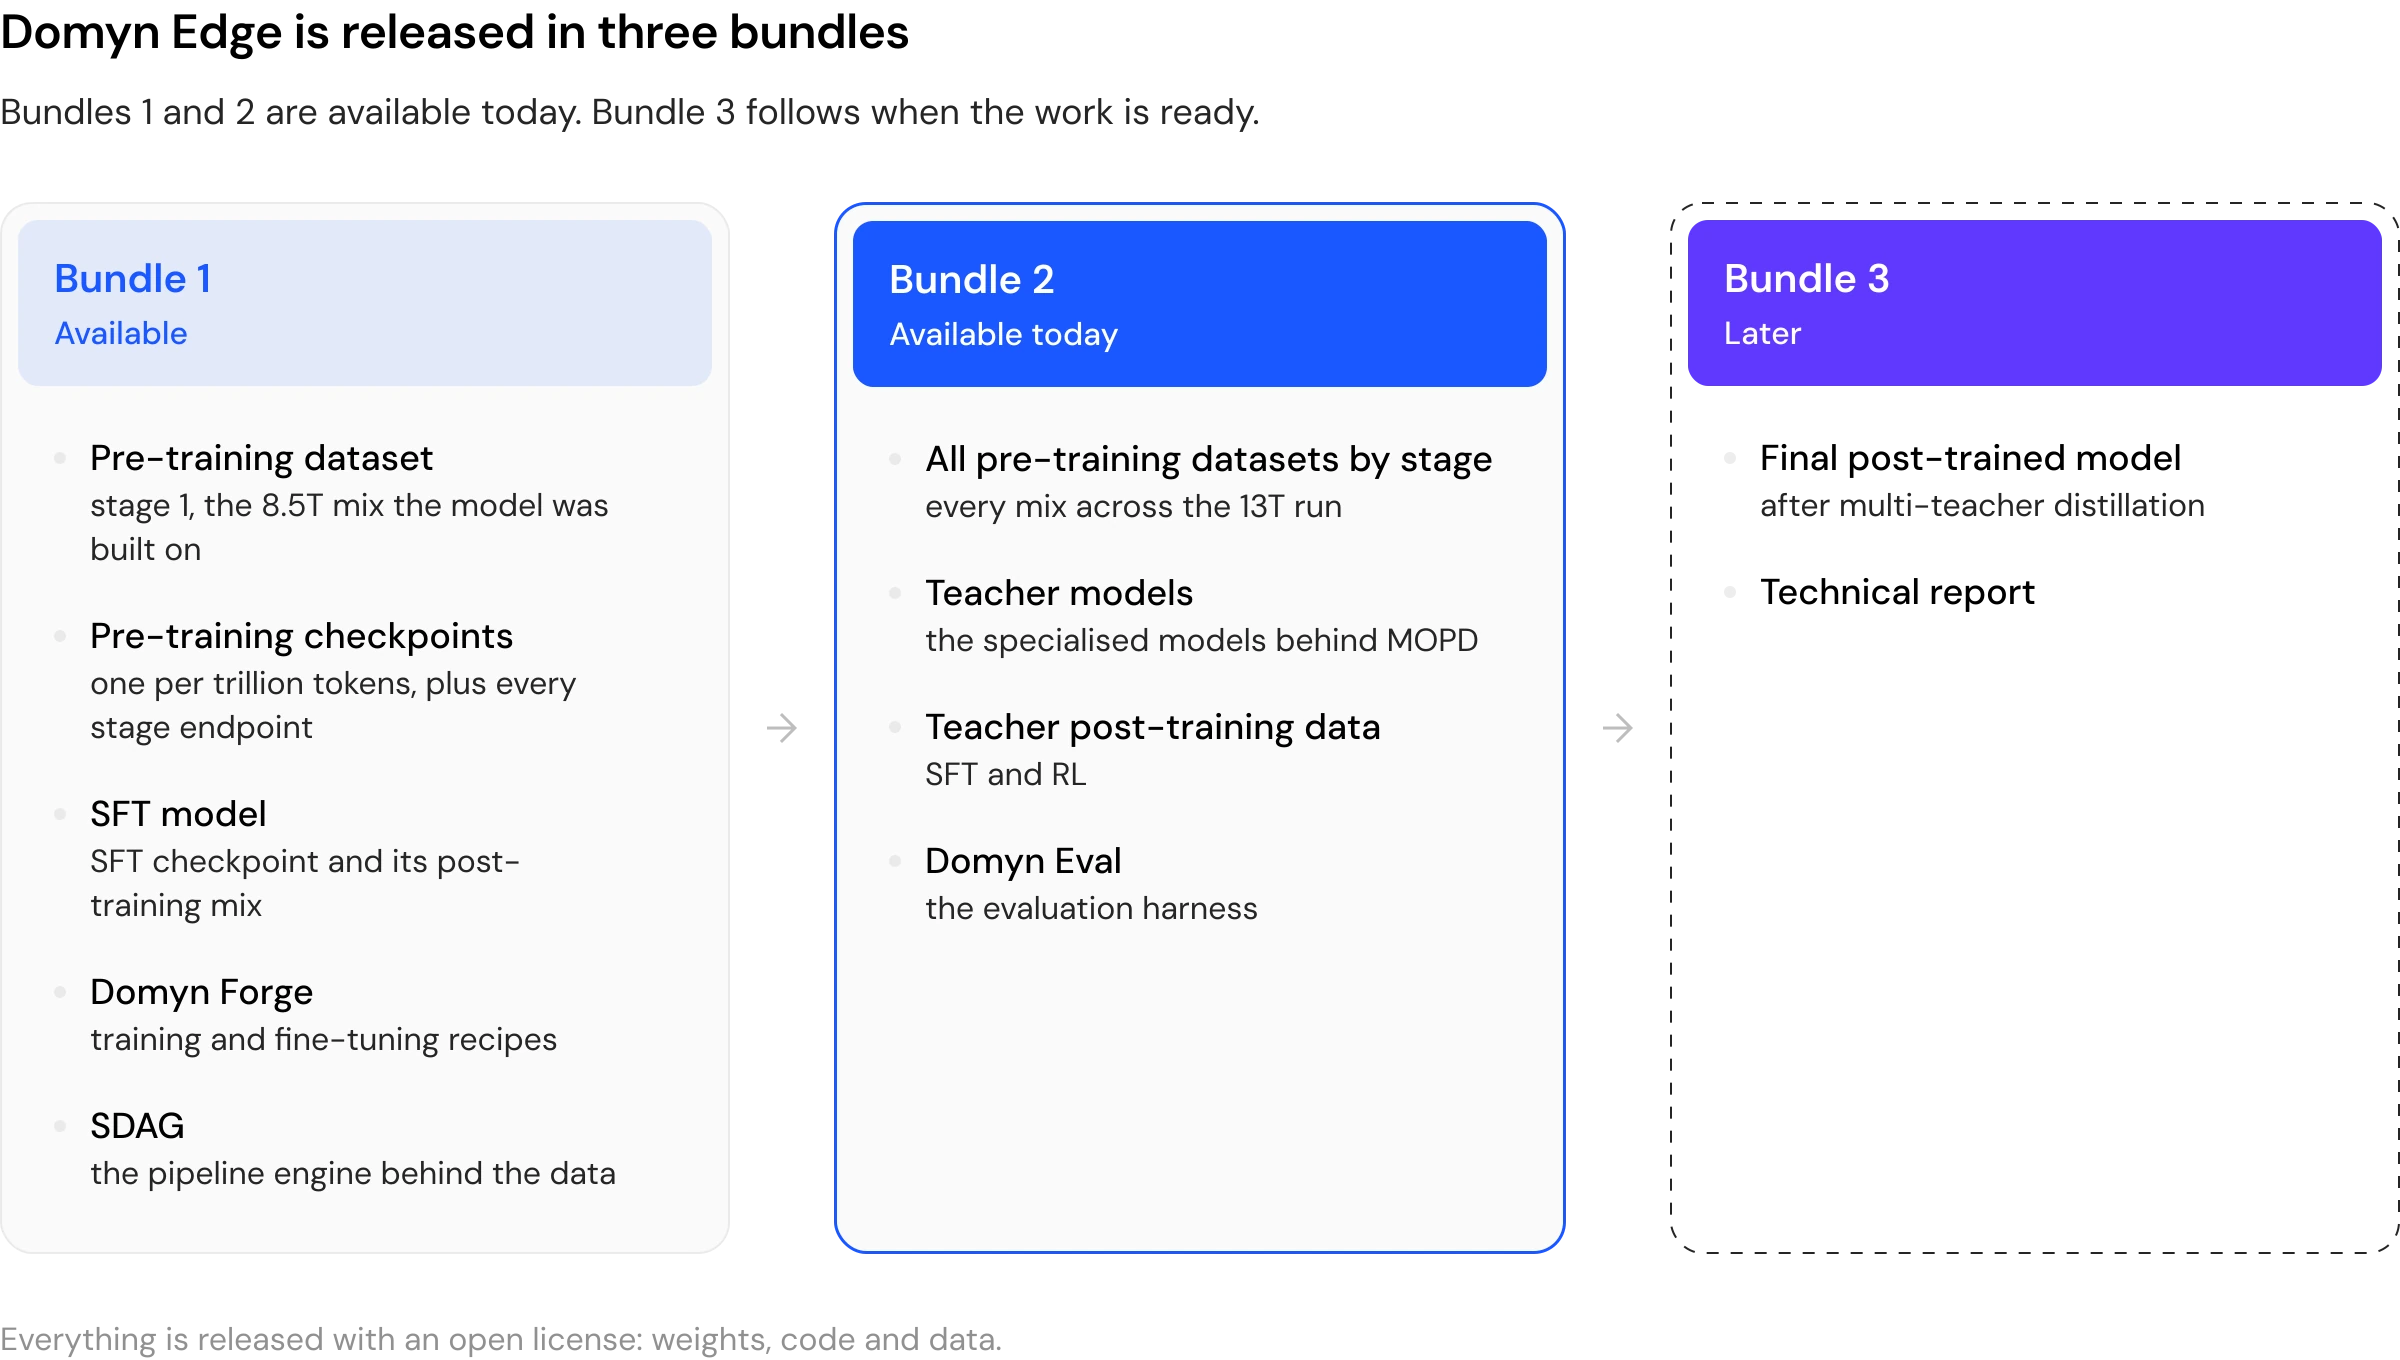
Domyn Edge viene rilasciato in tre bundle ed è completamente open. Il primo bundle, già rilasciato, comprende il modello base pre-addestrato, con un checkpoint per ogni trilione di token di pre-training e il checkpoint finale di ciascuna fase, oltre al dataset di pre-training della fase 1, al checkpoint SFT (lo student) e a Domyn Forge, il codice di addestramento. Ogni componente è distribuito con licenza Apache 2.0: il modello può quindi essere esaminato, verificato, riprodotto e ulteriormente addestrato.
Con il secondo bundle, disponibile da oggi, pubblichiamo la prima fase del post-training. Rilasciamo i cinque modelli teacher, ovvero gli specialisti di dominio su cui si basa il nostro protocollo di distillazione, insieme ai dati usati per addestrarli. A questi si aggiungono il mix di dati supervisionati con cui è stato addestrato lo student, i dataset di pre-training delle fasi dalla 2 alla 6, che completano quello della fase 1 incluso nel primo bundle, e Domyn Eval, il framework di valutazione open source con cui misuriamo tutti i risultati.
A cosa servono i teacher specializzati
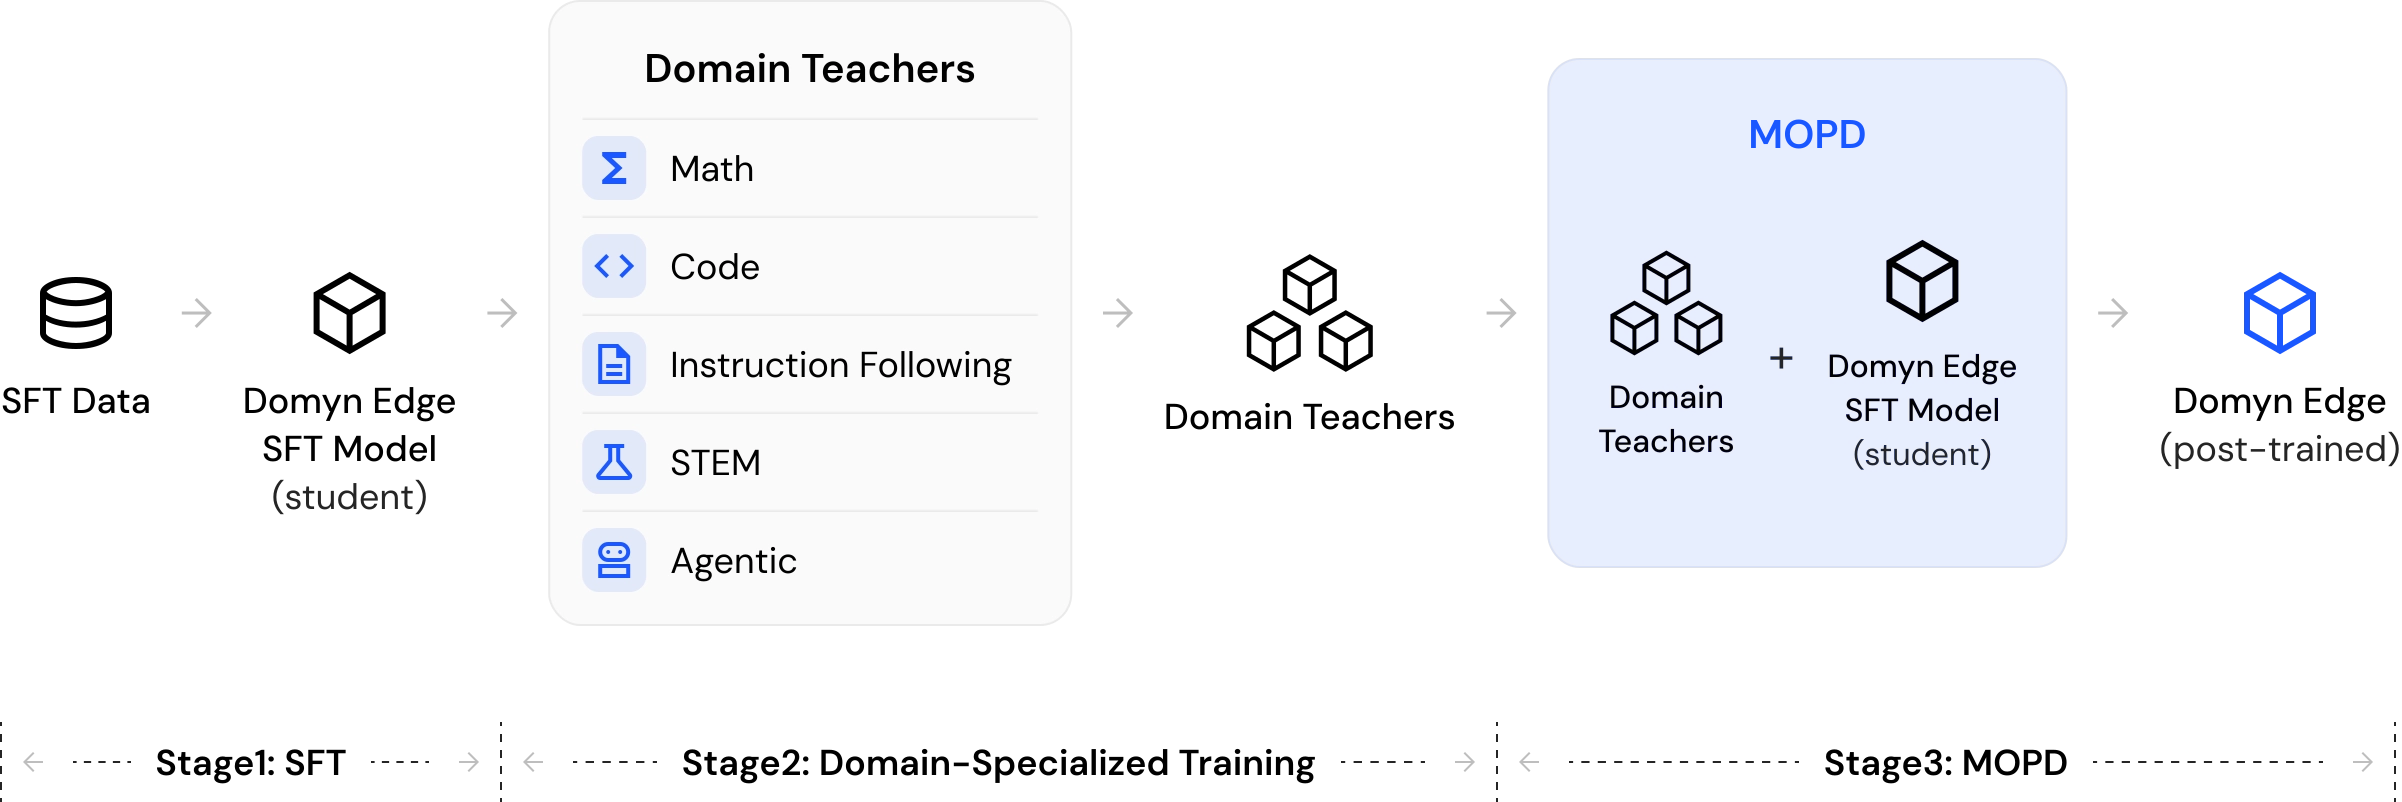
Il post-training di Domyn Edge si basa sulla Multi-Teacher On-Policy Distillation (MOPD) [1]. Addestriamo uno specialista distinto per ciascun dominio di competenza, poi li distilliamo tutti in un unico student che conserva quanto appreso da ognuno. Con questo bundle rilasciamo i teacher; il modello distillato arriverà con il Bundle 3.
Tutti e cinque i teacher partono dallo stesso checkpoint, domyn/Domyn-Edge-SFT, già rilasciato. Ciascuno viene prima sottoposto a un addestramento supervisionato sul proprio dominio, poi addestrato con GRPO su ricompense verificabili nello stesso ambito, tramite NeMo RL. La distillazione avviene quindi sui rollout generati dallo student stesso: tutti i teacher valutano gli stessi output, e lo student apprende dal loro giudizio.
Rilasciamo i teacher come artefatti intermedi che rendono riproducibile il modello finale. Diversi di loro hanno anche un valore autonomo, per chi ha bisogno di una singola competenza più che di un modello generalista.
I cinque teacher
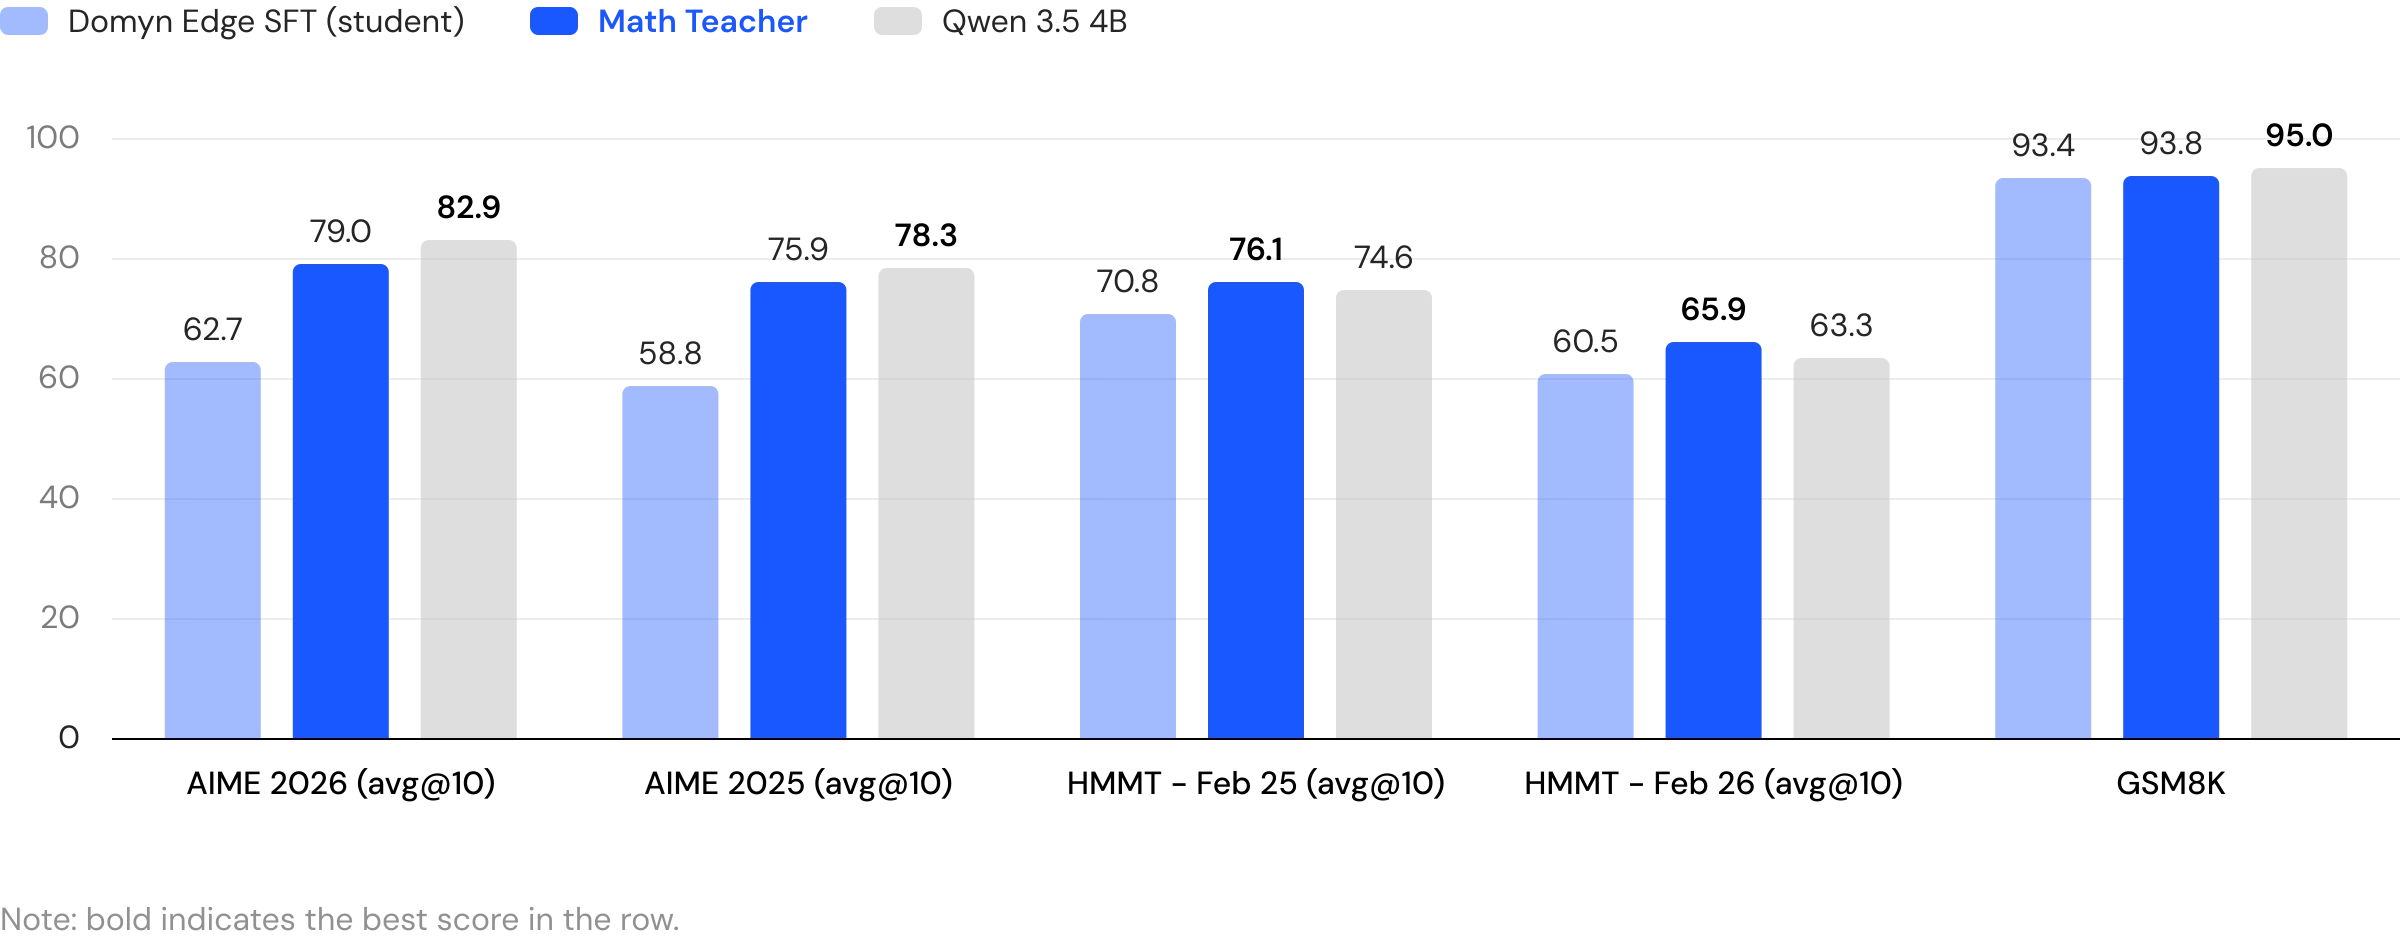
Math. Problemi matematici di livello competitivo, tratti da gare e olimpiadi della matematica, valutati su AIME 2025, AIME 2026, HMMT e MATH. Alla fase supervisionata segue un addestramento GRPO con un verificatore delle risposte, che penalizza le risposte corrette restituite nel formato sbagliato.
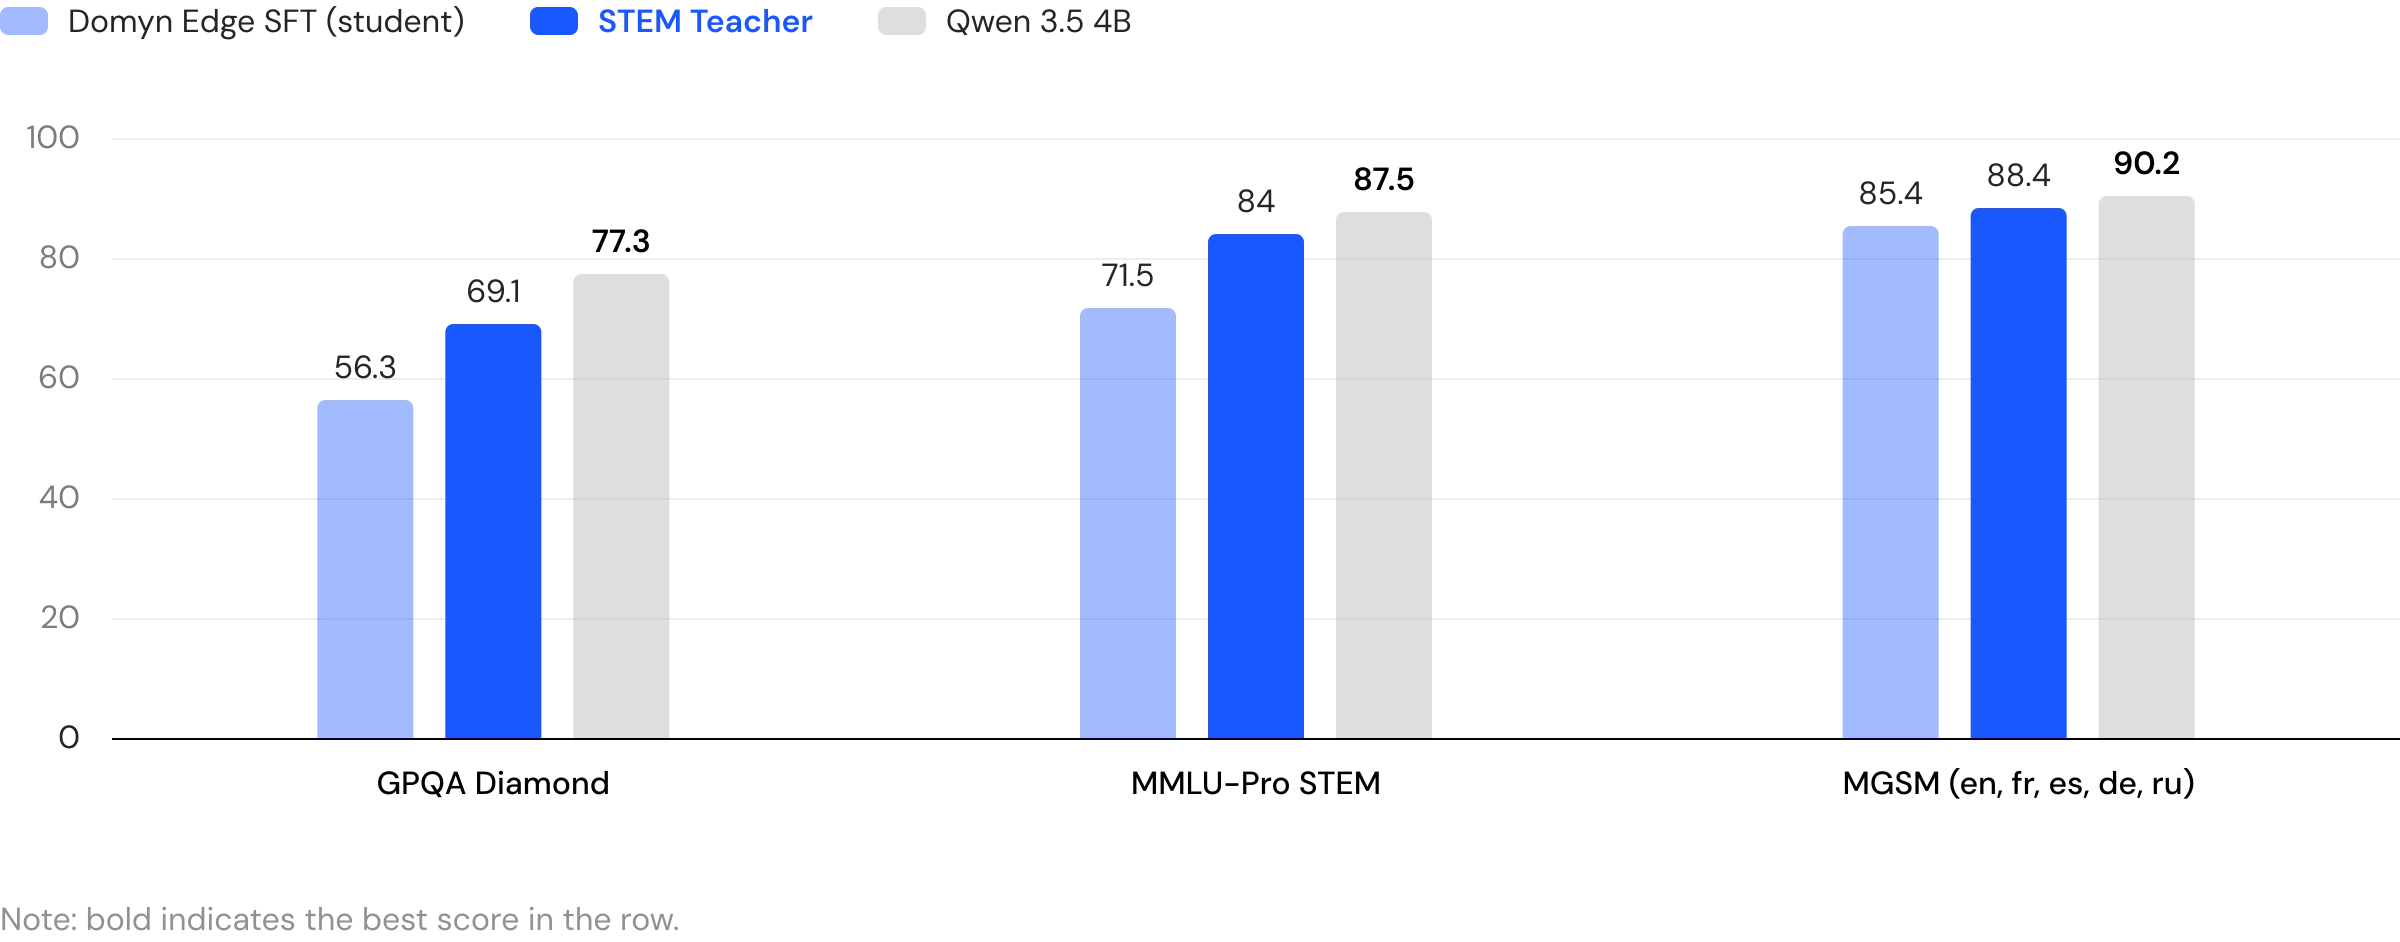
STEM. Ragionamento scientifico e quantitativo su domande a scelta multipla, valutato su GPQA Diamond, MMLU-Pro e MGSM.
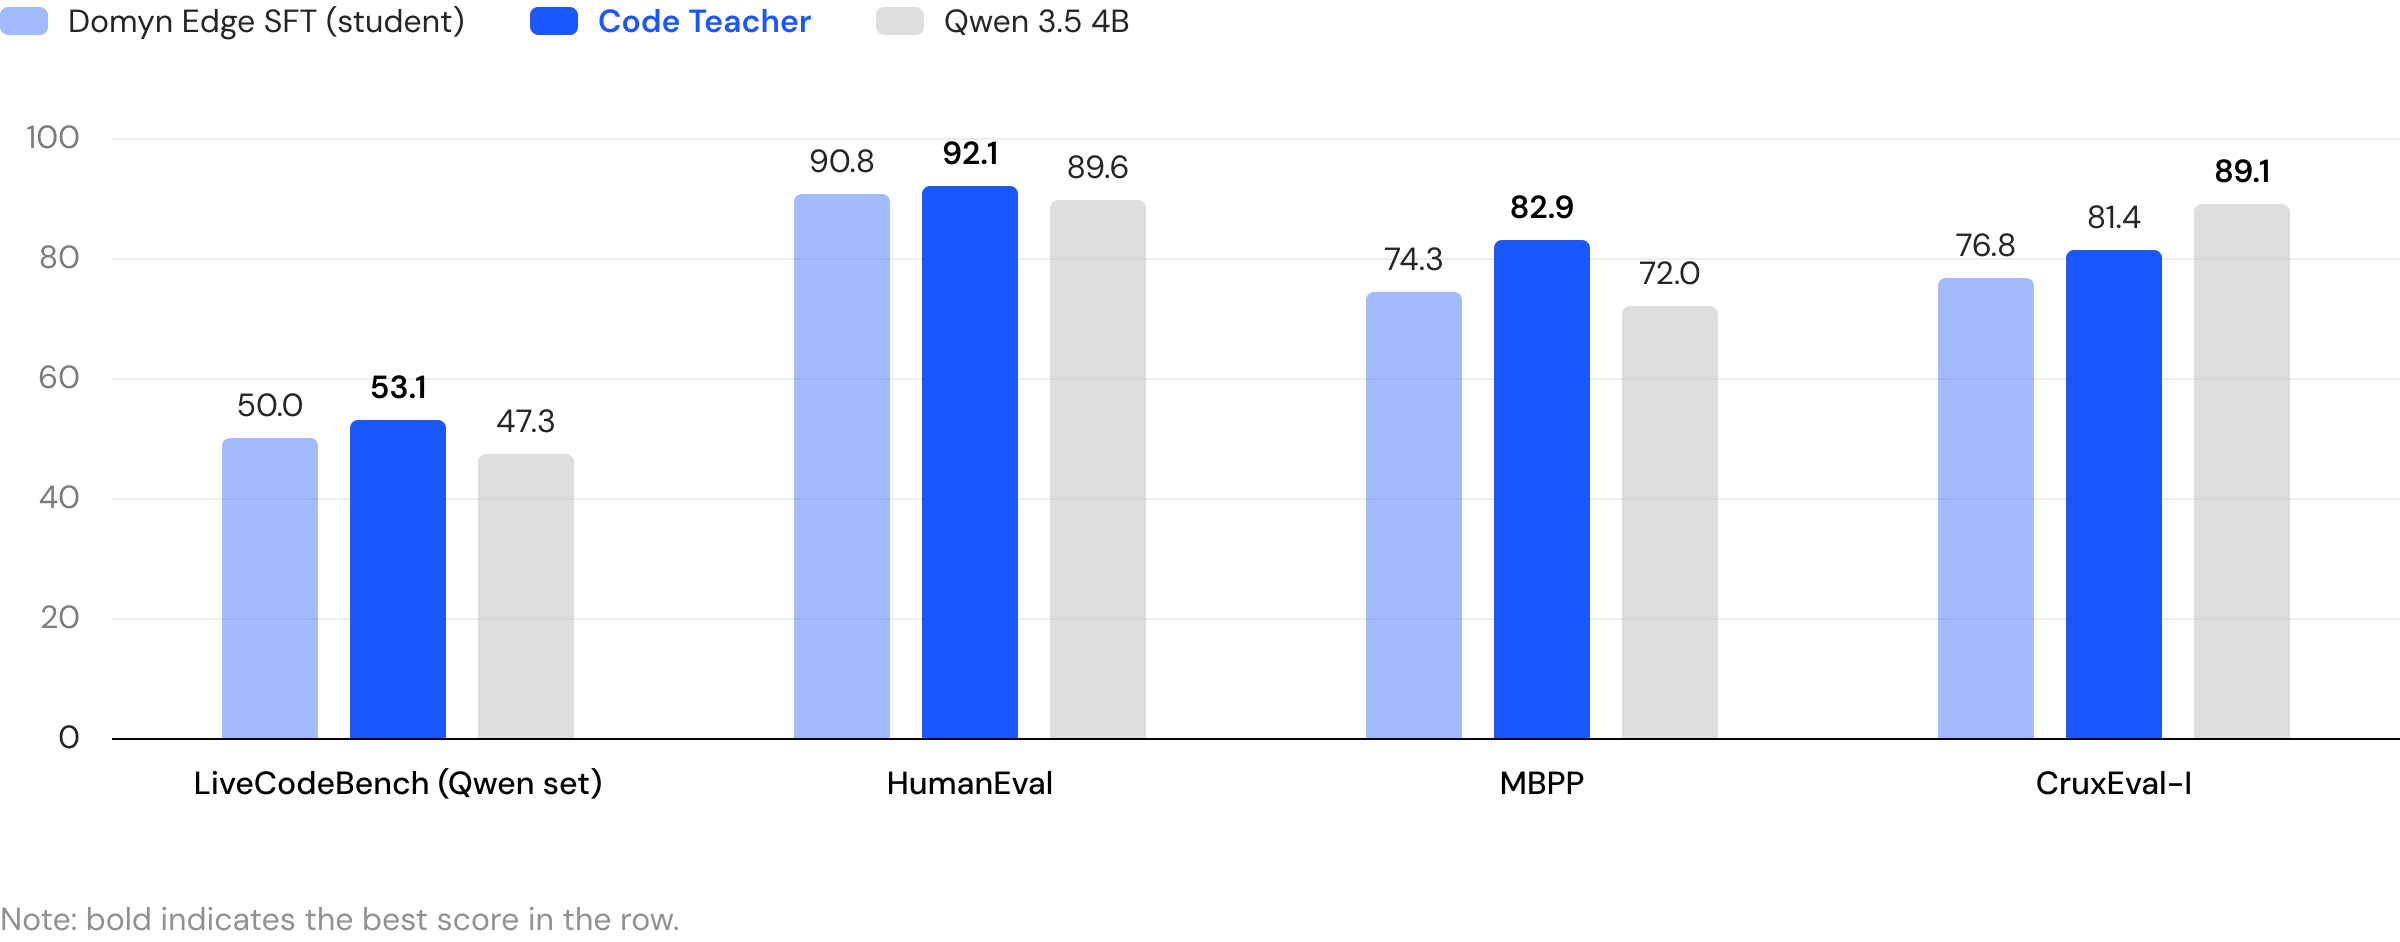
Code. Scrittura e comprensione del codice, valutate su LiveCodeBench, LiveBench Coding, BigCodeBench, HumanEval, MBPP e CruxEval. L’addestramento avviene con un contesto di 64k, il limite entro cui il codice generato resta coerente.
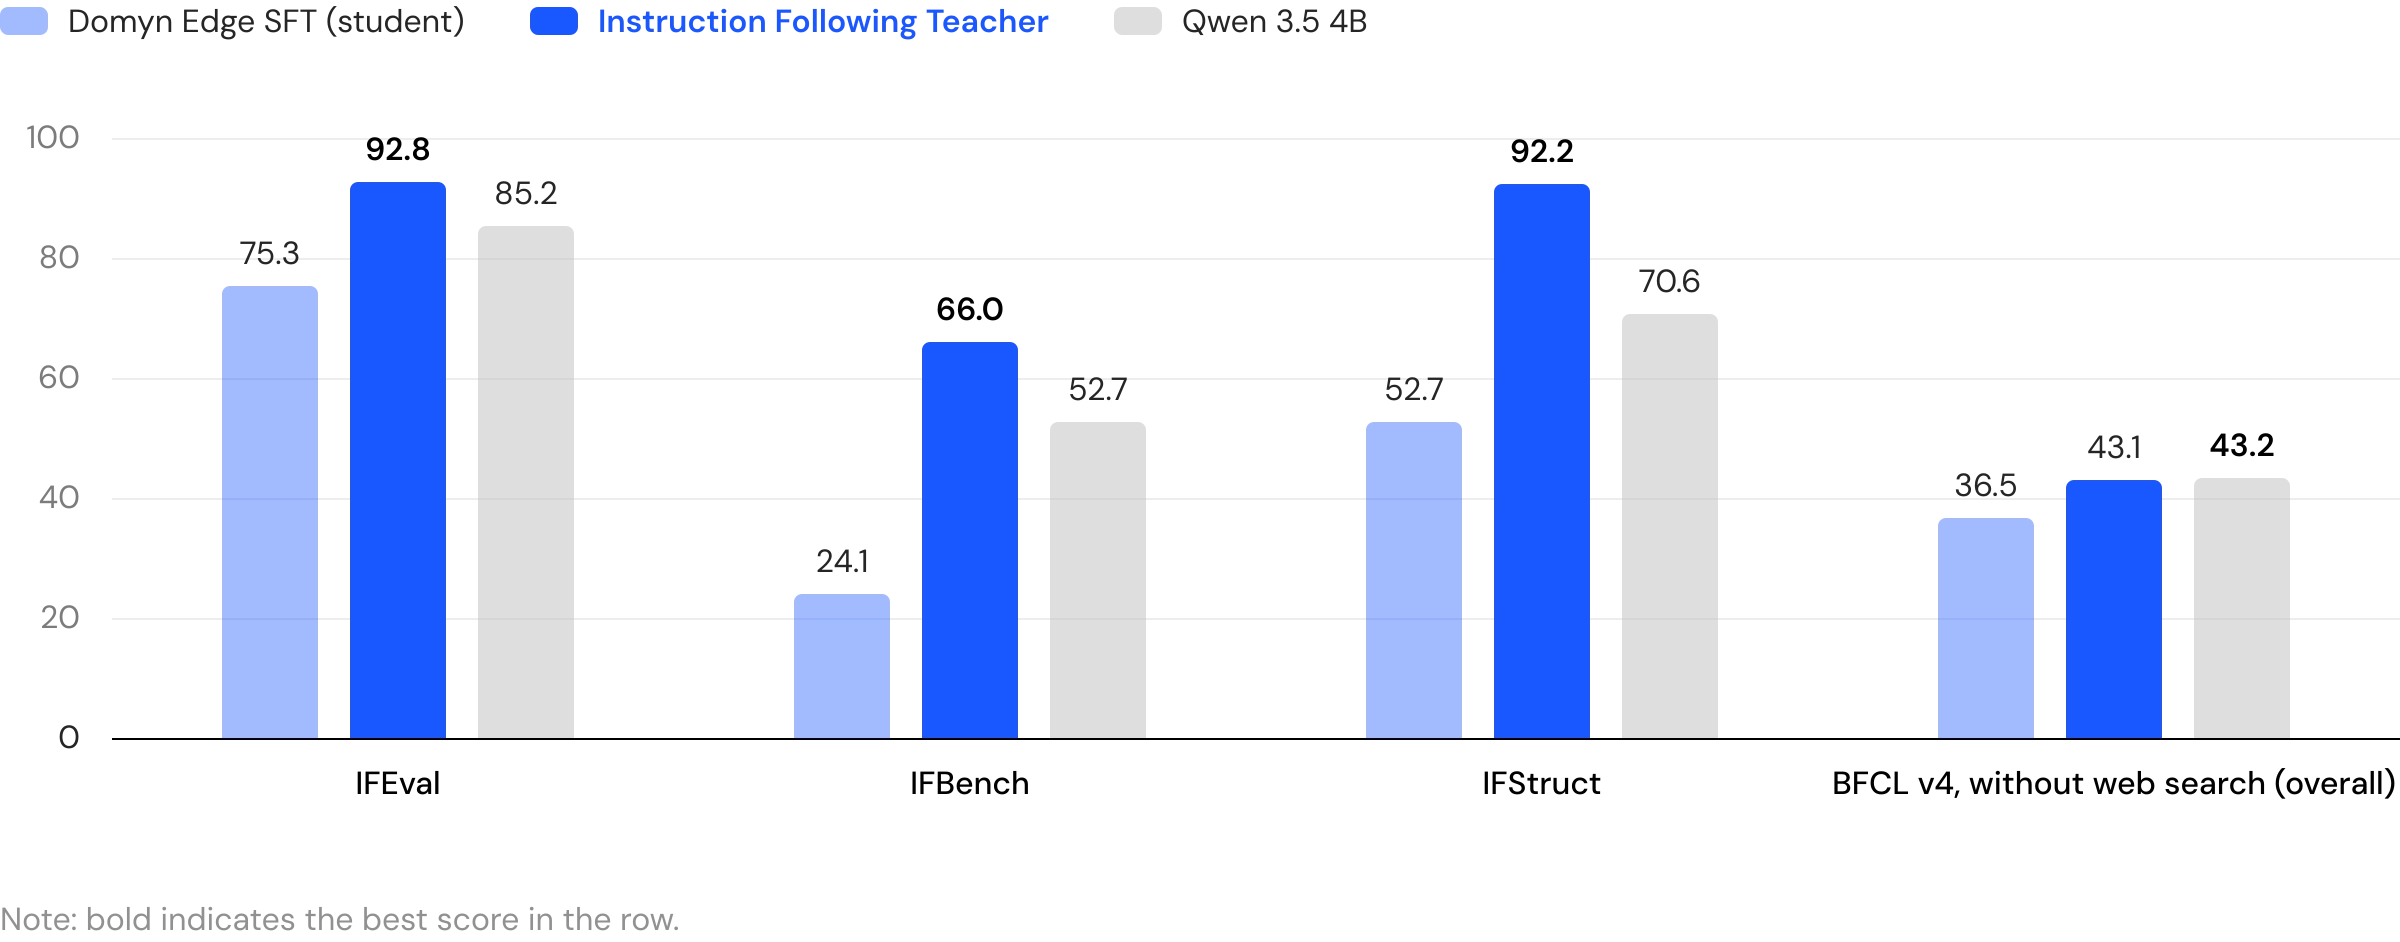
Instruction following. Rispetto di istruzioni e uso di strumenti esterni (tool calling), valutati su IFEval, IFBench, IFStruct, IFExtract e sulla sezione a turno singolo di BFCL v4.
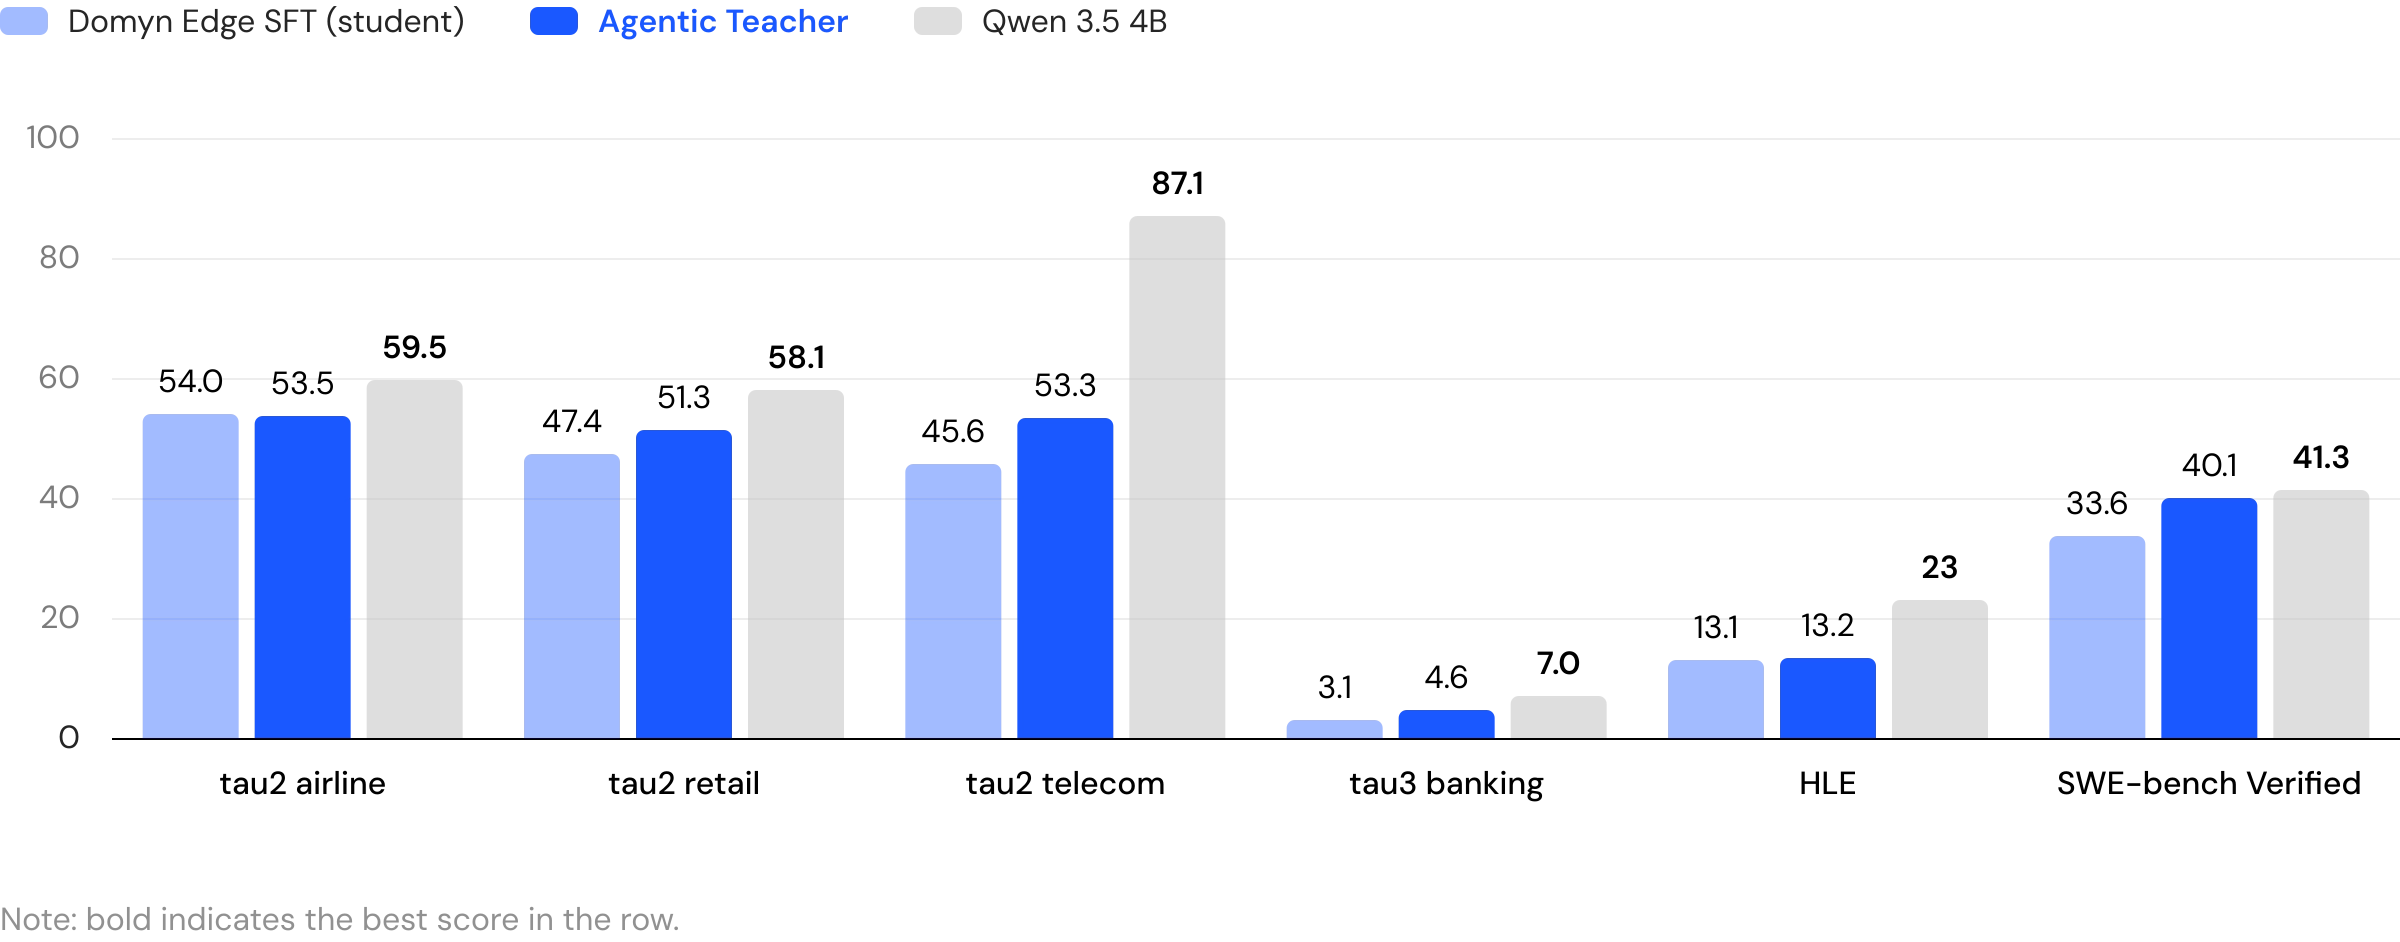
Agentic. Compiti complessi da svolgere in autonomia su più passaggi: dall’uso del terminale allo sviluppo software, valutati su tau2-bench, tau3-bench, Terminal-Bench, la sezione multi-turno di BFCL v4 e SWE-bench Verified.
La model card di ogni teacher riporta la ricetta di addestramento completa: framework e versione, numero di nodi e ripartizione tra generazione e training, lunghezza di contesto e di sequenza, learning rate e relativo schedule, dimensione del batch e rollout per prompt, coefficiente KL, clipping, numero di step e tempo di esecuzione, oltre alla specifica della ricompensa e al verificatore utilizzato.
Risultati
Tutti i valori riportati sono pass@1, misurati con domyn-eval con un unico chat template e un’unica configurazione di campionamento. I risultati AIME sono la media di dieci esecuzioni e sono riportati con la relativa deviazione standard. Il modello di riferimento è Qwen 3.5 4B, come anche nella model card dello student.
Ogni teacher valutato nel proprio ambito
Una tabella per ciascun teacher, ognuna relativa alla suite su cui quel teacher è stato addestrato. Lo student è il checkpoint da cui partono tutti i teacher: il confronto tra la colonna centrale e la prima mostra il contributo della specializzazione, quello tra la colonna centrale e l’ultima indica il nostro posizionamento rispetto al modello di riferimento.
Teacher Math
Teacher STEM
Teacher Code
Teacher Instruction Following
Teacher Agentic
I dati
Pre-training, fasi da 2 a 6. Il Bundle 1 ha reso disponibile il mix della fase 1, pari a 8,4 trilioni di token unici, come domyn/Domyn-Edge-Pretraining-Mix-8.4T. Questo secondo bundle rilascia i cinque mix successivi in un unico repository, con una config per ciascuna fase. Ogni config è associata a un branch di domyn/Domyn-Edge-Base-checkpoints: con il checkpoint iniziale, i dati e la ricetta di Domyn Forge, ogni fase può essere riprodotta in modo indipendente.
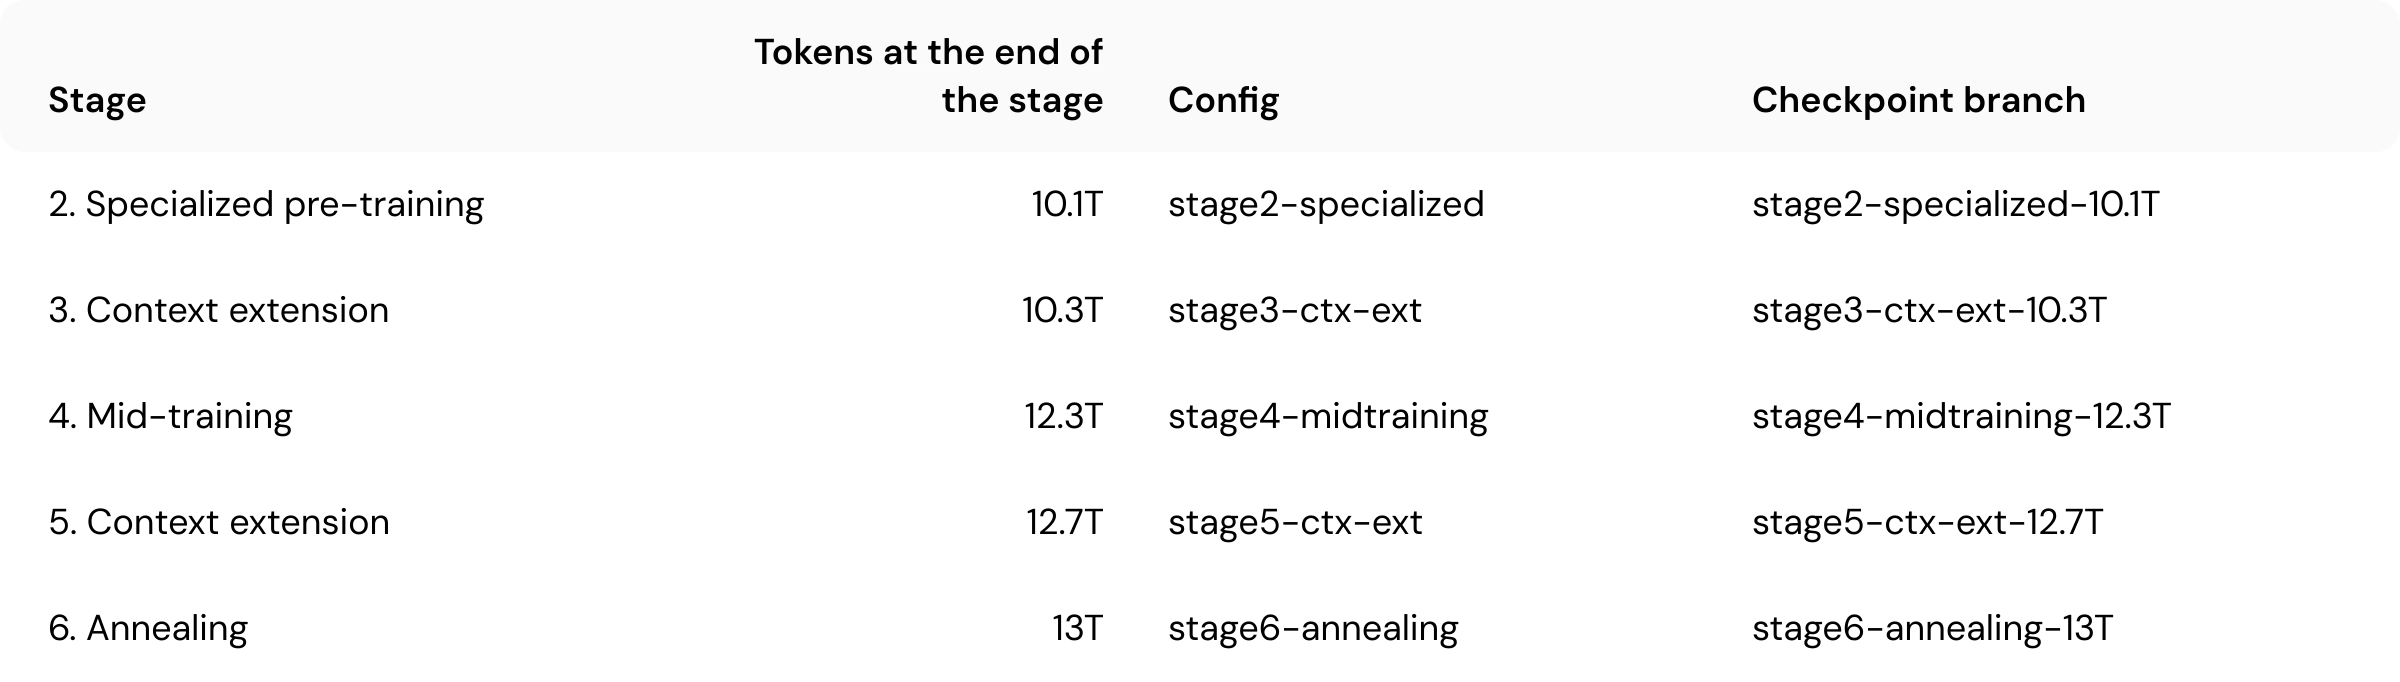
Ogni fase ha un obiettivo specifico. La fase 2 aumenta la quota di dati dedicati a ragionamento, matematica e codice, con un contesto di 16k. La fase 3 estende per la prima volta la finestra di contesto, da 16k a 64k. La fase 4 introduce esempi di interazioni agentiche, basate su tool calling e programmazione, con un contesto di 32k. La fase 5 porta il contesto di addestramento a 1 milione di token. La fase 6 riduce progressivamente il learning rate in due passaggi, il primo con un contesto di 64k e il secondo di 512k.
Il mix SFT dello student. Il mix supervisionato alla base di domyn/Domyn-Edge-SFT è disponibile come domyn/Domyn-Edge-SFT-Mix, con una config per ciascuna fase supervisionata: 64k, 128k-cascade e 512k-cascade, rispettivamente da 228,1B, 29,8B e 57,3B token. La dataset card elenca ogni fonte con link e licenza, il numero di campioni e di token per fonte, e le operazioni di filtraggio e decontaminazione applicate. Due set sono stati generati da noi e sono contrassegnati come tali nella tabella precedente: uno di question answering su contesti lunghi e uno di interazioni di tool calling registrate su una piattaforma agentica live. Solo una parte dei dati non viene rilasciata: quella relativa all’identità del modello. Per questo il numero di token per fase è inferiore a quello indicato nella model card.
I mix dei teacher. Ogni teacher dispone di un proprio repository di dati, con una config SFT e, dove è stato applicato il reinforcement learning, una config RL. La config sft è composta da conversazioni; la config rl da prompt con le relative risposte verificabili o con le specifiche dell’ambiente di esecuzione. Ogni dataset card descrive la composizione del mix e cita ciascuna fonte di terze parti utilizzata, con la rispettiva licenza.
La licenza Apache 2.0 si applica solo ai materiali sviluppati da Domyn: i corpora a monte mantengono le proprie condizioni di licenza originali, indicate nelle singole dataset card.
Domyn Eval: il framework di valutazione
Tutti i valori riportati in questo articolo sono stati ottenuti con domyn-eval, che rilasciamo insieme a questo secondo bundle con licenza Apache 2.0. Il framework orchestra suite di valutazione esterne attraverso un’unica interfaccia e le esegue su cluster SLURM, rendendo disponibile il modello in esame tramite Domyn Swarm. Include le configurazioni utilizzate per produrre le tabelle precedenti, così che i risultati siano riproducibili.
Riprodurre un punteggio pubblicato su un benchmark è più difficile di quanto sembri. Due punteggi sono confrontabili solo se ottenuti con gli stessi parametri di campionamento, chat template, set di prompt, modelli giudice e versioni delle suite di riferimento. In domyn-eval ogni valutazione è definita da un file di configurazione, quindi un risultato può essere riprodotto nelle stesse condizioni in cui è stato generato. A partire da quel file, il framework esegue le suite, avvia il modello e restituisce i risultati.
- Molte suite, un’unica interfaccia. Suite come Inspect AI e lm-evaluation-harness sono integrate così come vengono pubblicate, ciascuna vincolata a una versione specifica e isolata dalle altre. Aggiungere una nuova suite non richiede modifiche a quelle esistenti. I risultati vengono restituiti tutti nello stesso formato, così un modello può essere valutato su più suite in un’unica esecuzione.
- Esecuzione e valutazioni su cluster. Domyn Swarm rende disponibile il modello in esame tramite vLLM, con un secondo endpoint dedicato al modello giudice. I benchmark che eseguono il codice generato vengono valutati in una sandbox, isolata dal sistema host e dagli altri benchmark.
- Verifiche preliminari, prima di impiegare risorse di calcolo. Configurazione, ambiente ed endpoint vengono verificati prima dell’avvio di ogni esecuzione.
- Un unico report, basato su configurazioni versionate. Ogni esecuzione conserva la propria configurazione insieme a log e risultati. In fase di reporting, questi dati vengono raccolti in una tabella per ciascun modello o in una classifica comparativa tra modelli.
- Punteggi e statistiche di dettaglio. Per ogni benchmark, il report indica anche il numero di risposte troncate, vuote, non valutabili o degenerate in ripetizioni cicliche.
Prossimo passo: il Bundle 3
Il Bundle 3 renderà disponibile il modello Domyn Edge finale, quello che raccomandiamo per l’uso generale, ottenuto distillando i cinque teacher nello student tramite MOPD. Lo student genera i rollout, ciascun teacher li valuta e lo student viene addestrato su questo segnale. Il risultato è un unico modello generalista che eredita quanto appreso da ciascuno specialista. Il rilascio sarà accompagnato da un report tecnico che illustrerà la provenienza dei dati, la composizione e i pesi di campionamento di ogni fase, gli studi di ablazione su architettura e tokenizer e quanto abbiamo imparato lungo il percorso.
Nel frattempo, le ricette di addestramento sono disponibili nelle model card dei teacher e la composizione di ciascun mix nelle dataset card. Correzioni e domande su qualunque artefatto rilasciato sono benvenute.
Risorse
Bundle 2
- Modelli teacher: Math, STEM, Code, Instruction following, Agentic
- Mix di dati dei teacher: Math, STEM, Code, Instruction following, Agentic
- Mix SFT dello student: domyn/Domyn-Edge-SFT-Mix
- Dataset di pre-training per fase: domyn/Domyn-Edge-Pretraining-Mix-Stages
- Framework di valutazione: domyn-eval su GitHub
Bundle 1
- Modello base: domyn/Domyn-Edge-Base
- Checkpoint di pre-training: domyn/Domyn-Edge-Base-checkpoints
- Dataset di pre-training della fase 1: domyn/Domyn-Edge-Pretraining-Mix-8.4T
- Modello student: domyn/Domyn-Edge-SFT
- Codice di addestramento: Domyn Forge su GitHub
- Strumenti HPC: Domyn Swarm e SDAG su GitHub
- Collezione: Domyn Edge su Hugging Face
Riferimenti
[1] Ma, W., et al. (2026). MOPD: Multi-Teacher On-Policy Distillation for Capability Integration. arXiv:2606.30406.


Domande frequenti