Iscriviti alla nostra newsletter
Ricevi ogni mese tanti insight sul mondo dell’Intelligenza Artificiale e sulle ultime novità di iGenius.
Iscriviti
Domyn Logo Glyph
Domyn Research
Technical Team
Pubblicato il
15
October
2026
|
14 min
|

Specializzare NVIDIA Nemotron 3.5 Super VL per migliorare l’estrazione di knowledge graph finanziari

In questo articolo
Consigliati
No items found.
Le relazioni finanziarie annuali, come i 10-K, contengono fatti sulle attività, sui risultati e sui rischi di un’azienda. Per svolgere analisi finanziarie affidabili, gli agenti AI devono saper collegare questi fatti, per esempio associando i ricavi a un segmento di business o un rischio all’attività su cui incide.

I knowledge graph forniscono proprio questa struttura e sono ormai una componente chiave per fondare su dati verificabili il ragionamento degli agenti AI in ambito finanziario. Consentono così agli utenti di orientarsi in scenari finanziari complessi con il supporto di agenti AI le cui risposte sono sempre riconducibili a fonti verificate, a garanzia della loro affidabilità e della conformità normativa.

Costruire knowledge graph con un approccio agentico richiede diverse fasi, come abbiamo descritto nel paper FinReflectKG: individuare i fatti potenzialmente rilevanti, verificarli e strutturare quelli confermati in triple, ovvero coppie di entità unite da una relazione. L’efficacia di queste pipeline agentiche dipende dalla capacità del modello sottostante di svolgere ciascuna fase sulle porzioni di un 10-K, sia separatamente sia combinandole in un’unica richiesta.

Perché un knowledge graph possa collegare informazioni provenienti da porzioni e documenti diversi, riconoscere i fatti è solo una parte del lavoro. Il modello deve anche esprimerli in modo coerente, usando per entità e relazioni i nomi previsti dall’ontologia, cioè dallo schema che organizza la conoscenza.

Per migliorare la precisione e la recall dei modelli nell’estrazione di informazioni strutturate secondo un’ontologia specifica, abbiamo eseguito il fine-tuning di NVIDIA Nemotron 3.5 Super VL perché leggesse una porzione di un documento 10-K e ne estraesse i fatti sotto forma di triple strutturate, come (NKE, Discloses, Revenue). Abbiamo addestrato il modello con NVIDIA Megatron-Bridge e le sue configurazioni di addestramento predefinite, e lo abbiamo eseguito con vLLM per la valutazione.

Il flusso di lavoro che abbiamo messo a punto mostra come si possa specializzare un modello su sottodomini e compiti specifici. In questo caso, abbiamo testato il modello sui documenti di sette aziende mai viste in addestramento, valutando gli output in base all’ontologia pubblica di FinReflectKG. I risultati mostrano che il modello specializzato individua più fatti di riferimento e li esprime in modo coerente con l’ontologia richiesta.

 Nello specifico, il modello specializzato:

  • individua il doppio dei fatti di riferimento del benchmark con un solo ciclo di estrazione, passando dal 16% al 33%, e supera sia il modello di partenza sia i modelli chiusi più avanzati nello stesso compito;
  • produce in media una quota più alta di triple corrette per porzione, secondo la valutazione di un LLM giudice: dal 64% al 72%;
  • migliora in misura analoga anche nei settori non inclusi nell’addestramento: nell’ambito dell’energia e della sanità, con un’azienda di test ciascuno, la quota di fatti di riferimento individuati cresce di 17 punti;
  • commette meno della metà delle violazioni delle regole, che riguardano il 3,8% delle triple anziché l’8,7%.

Questi risultati sono stati ottenuti con soli 1.978 esempi di addestramento: un insieme relativamente ridotto, che rende il processo replicabile su altri casi d’uso con costi e tempi contenuti.

Nelle sezioni seguenti descriviamo nel dettaglio la metodologia e i risultati, con un esempio concreto tratto da un documento finanziario.

‍

Costruire knowledge graph dai documenti 10-K

Costruire un knowledge graph a partire dai documenti 10-K significa individuare ed estrarre fatti del tipo "quale azienda produce cosa", "quale segmento genera quali ricavi”, "quale rischio incide su quale attività". La pipeline pubblica di FinReflectKG suddivide ogni documento in porzioni di pochi paragrafi o di una sola tabella, di circa 330 parole (valore mediano). Estrae poi i fatti di ciascuna porzione attraverso più chiamate a un LLM: un’estrazione, seguita da cicli di critica e correzione. Ogni fatto si basa su un elenco fisso di relazioni e tipi di entità ammessi, e i fatti provenienti da documenti diversi confluiscono in un knowledge graph globale. Il nostro obiettivo era eseguire il fine-tuning di Nemotron 3.5 Super VL per migliorare l’estrazione zero-shot, cioè senza esempi nel prompt, secondo ontologie specifiche.

‍

Metriche di valutazione

Le prestazioni del modello base e del modello specializzato sono state valutate secondo la seguente metodologia.

La recall è la quota di fatti di riferimento del benchmark che il modello riesce a individuare. I fatti di riferimento sono le triple che il benchmark considera corrette, generate dalla pipeline di FinReflectKG tramite LLM. La recall prevede tre livelli di rigore: la recall sulle coppie (pair recall) richiede l’individuazione delle due entità di un fatto di riferimento; la recall sulle triple (triple recall) richiede anche la relazione corretta tra le due entità; la recall tipizzata (typed recall) richiede infine la categoria di ciascuna entità. Ogni recall è calcolata come media su tutte le porzioni.

Un LLM giudice è un secondo modello linguistico che valuta l’output in base alla griglia di valutazione del benchmark. Abbiamo scelto Qwen3-32B, lo stesso modello adottato nel nostro articolo sulla costruzione di FinReflectKG, e gli abbiamo fornito i prompt di valutazione di FinReflectKG-EvalBench, in una configurazione a giudice singolo. Per ogni tripla il modello giudice assegna tre valutazioni: precisione (il fatto è corretto), fedeltà (il testo lo supporta) e pertinenza (il fatto è rilevante per il documento). Per l’intera porzione,  il modello giudice assegna un punteggio da 1 a 3 che misura quanta parte del contenuto è coperta dalle triple (completezza). Ogni punteggio assegnato è una media su tutte le porzioni. I risultati finali sono stati inoltre verificati tramite una valutazione umana.

Una tripla presenta una violazione delle regole quando infrange almeno una delle regole indicate nel prompt di estrazione fornito al modello: una regola dell’ontologia, come usare solo le relazioni ammesse o indicare l’azienda emittente con il suo ticker (NKE per Nike), oppure una regola di formato, come rispettare la lunghezza massima dei nomi delle entità. Il tasso di violazione è la quota di triple con almeno una violazione.
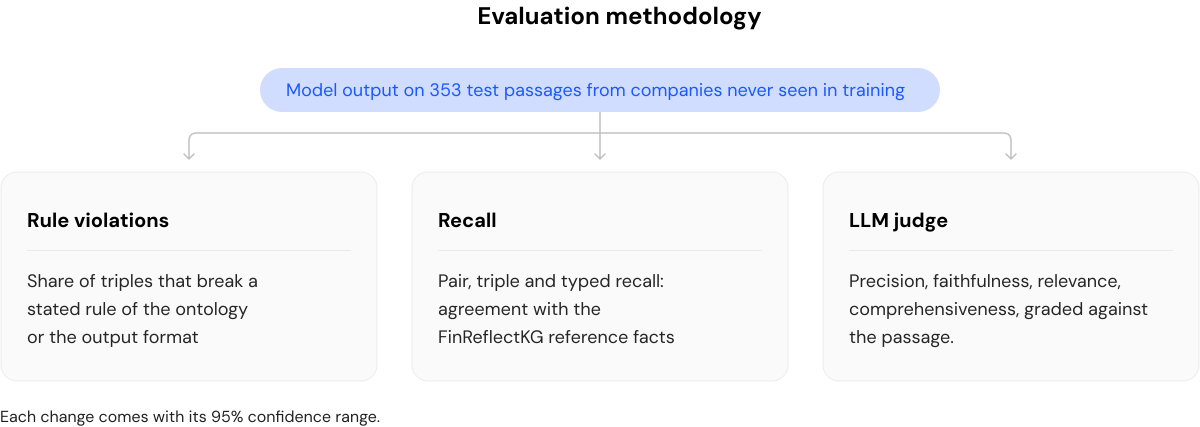
Diagram showing three evaluation methods for financial knowledge graph extraction: rule violations, recall against FinReflectKG reference facts, and LLM judge assessments of precision, faithfulness, relevance, and comprehensiveness, with 95% confidence ranges.
Il sistema di valutazione: violazioni delle regole, recall e LLM giudice

‍

Il nostro metodo di lavoro

Il punto di partenza: Nemotron 3.5 Super VL

Nemotron 3.5 Super VL, della famiglia Nemotron di NVIDIA, è il successore di Nemotron 3 Super. Già prima dell’addestramento, supera il suo predecessore sulle stesse 353 porzioni di test:
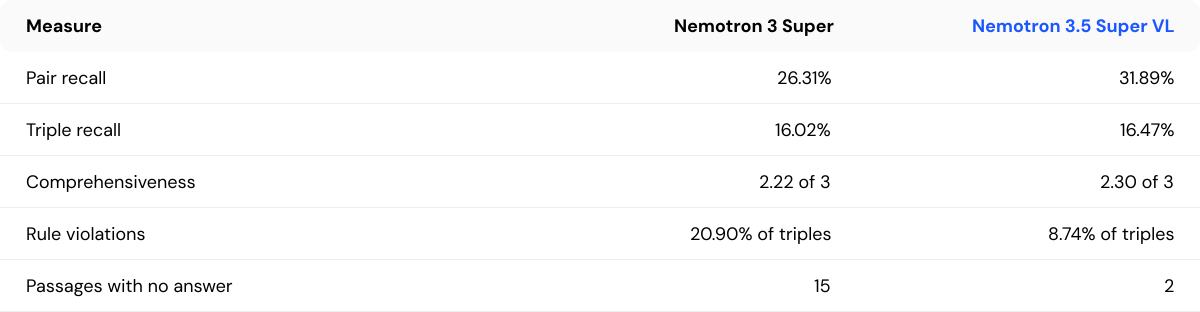
Comparison table showing Nemotron 3.5 Super VL outperforming Nemotron 3 Super in financial knowledge graph extraction, with higher pair and triple recall, better comprehensiveness, fewer rule violations, and fewer passages with no answer.

Rispetto al suo predecessore, Nemotron 3.5 Super VL individua più coppie di entità corrette, estrae da ogni porzione un numero maggiore di informazioni e ha un tasso di violazione inferiore alla metà. 

Il modello base non usa le etichette dell’ontologia, e la sua recall sulle triple si ferma infatti al 16%. Quando Nemotron 3.5 Super VL non individua un fatto di riferimento, di solito riconosce correttamente l’azienda, ma denomina l’altra entità in modo diverso dal benchmark oppure la omette.
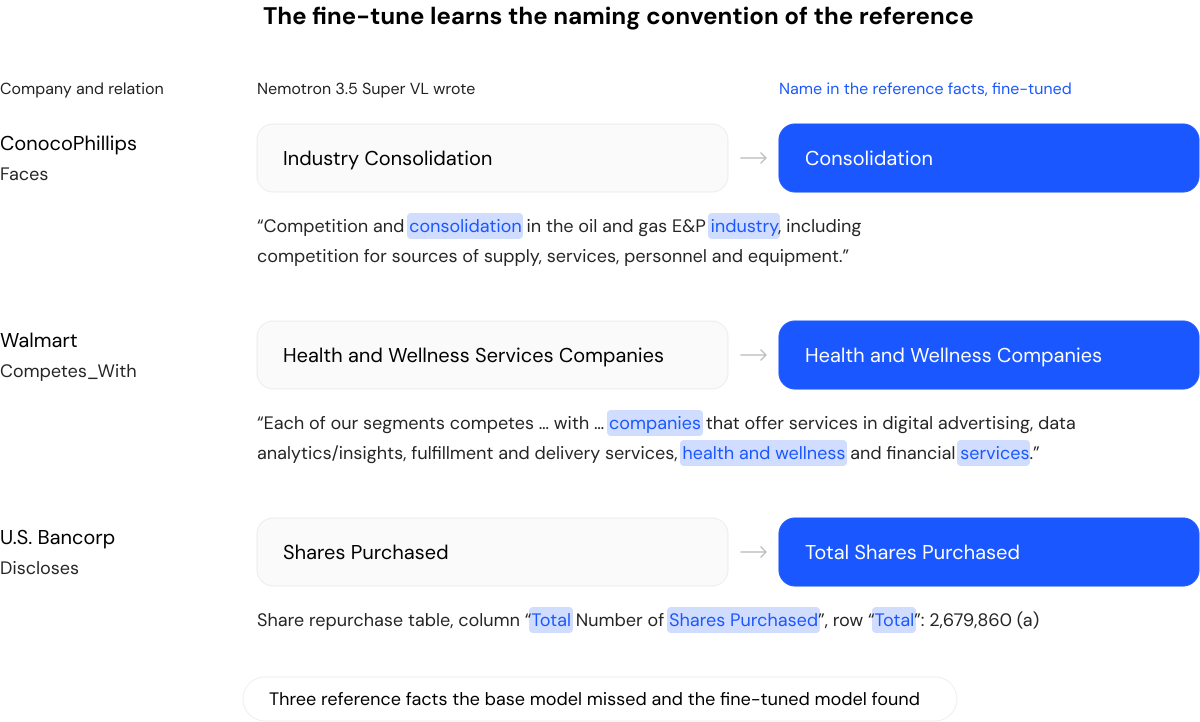
Diagram comparing entity and relation names generated by Nemotron 3.5 Super VL with fine-tuned reference names for financial knowledge graph extraction, highlighting naming differences across Faces, Competes_With, and Discloses relationships.
Il modello base denomina le entità in modo diverso dalla nomenclatura dell’ontologia. Confronto fra tre fatti non individuati: il nome usato dal modello base accanto a quello del benchmark, adottato dal modello specializzato.

Nemotron 3.5 Super VL dispone già delle conoscenze generali necessarie per questo compito. Con il fine-tuning, però, siamo riusciti a insegnargli ad applicare le regole dell’ontologia durante l’estrazione.

I dati di addestramento

Siamo partiti da FinReflectKG-EvalBench, la versione del nostro dataset FinReflectKG dedicata alla valutazione, e ne abbiamo estratto un sottoinsieme di esempi come training set, mantenendolo separato dall’insieme usato per la valutazione. A differenza del dataset principale, FinReflectKG-EvalBench associa a ogni tripla i giudizi di un LLM valutatore su precisione, fedeltà e pertinenza. Abbiamo considerato solo le 38 aziende per cui almeno il 30% delle triple ha superato tutti e tre i giudizi, perché un tasso inferiore indica una valutazione non riuscita. Tra queste, abbiamo selezionato le 2.435 porzioni che soddisfacevano tre criteri: punteggio di completezza massimo, almeno il 70% delle triple con esito positivo in tutti e tre i giudizi e solo relazioni comprese tra le 51 dell’ontologia. Queste porzioni rappresentano il 32% di tutte le porzioni con fatti di riferimento disponibili per quelle aziende.

Ogni porzione, insieme alle relative triple accettate, costituisce un esempio di addestramento. Abbiamo suddiviso gli esempi per azienda, in modo che il test avvenisse su aziende che il modello non aveva mai visto. Questa suddivisione è diversa da quella riportata nei nostri articoli su FinReflectKG, quindi i risultati non sono direttamente confrontabili con quelli pubblicati. Il validation set è un piccolo insieme di esempi tenuto da parte e usato per monitorare l’addestramento:
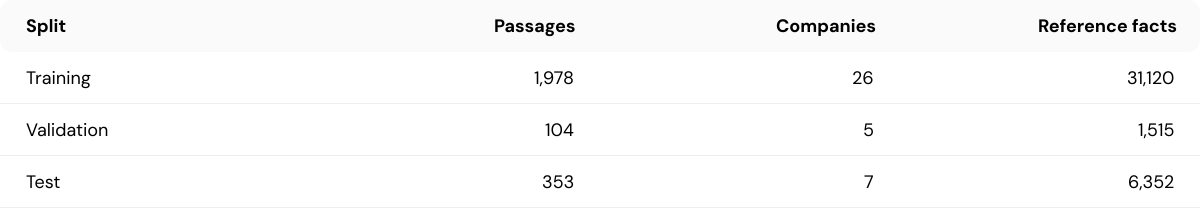
Table showing training, validation, and test dataset splits for financial knowledge graph extraction, with 1,978, 104, and 353 passages respectively, alongside company counts and reference facts for each split.

Due settori di test, energia e sanità, non hanno alcuna azienda nei set di addestramento e di validazione.
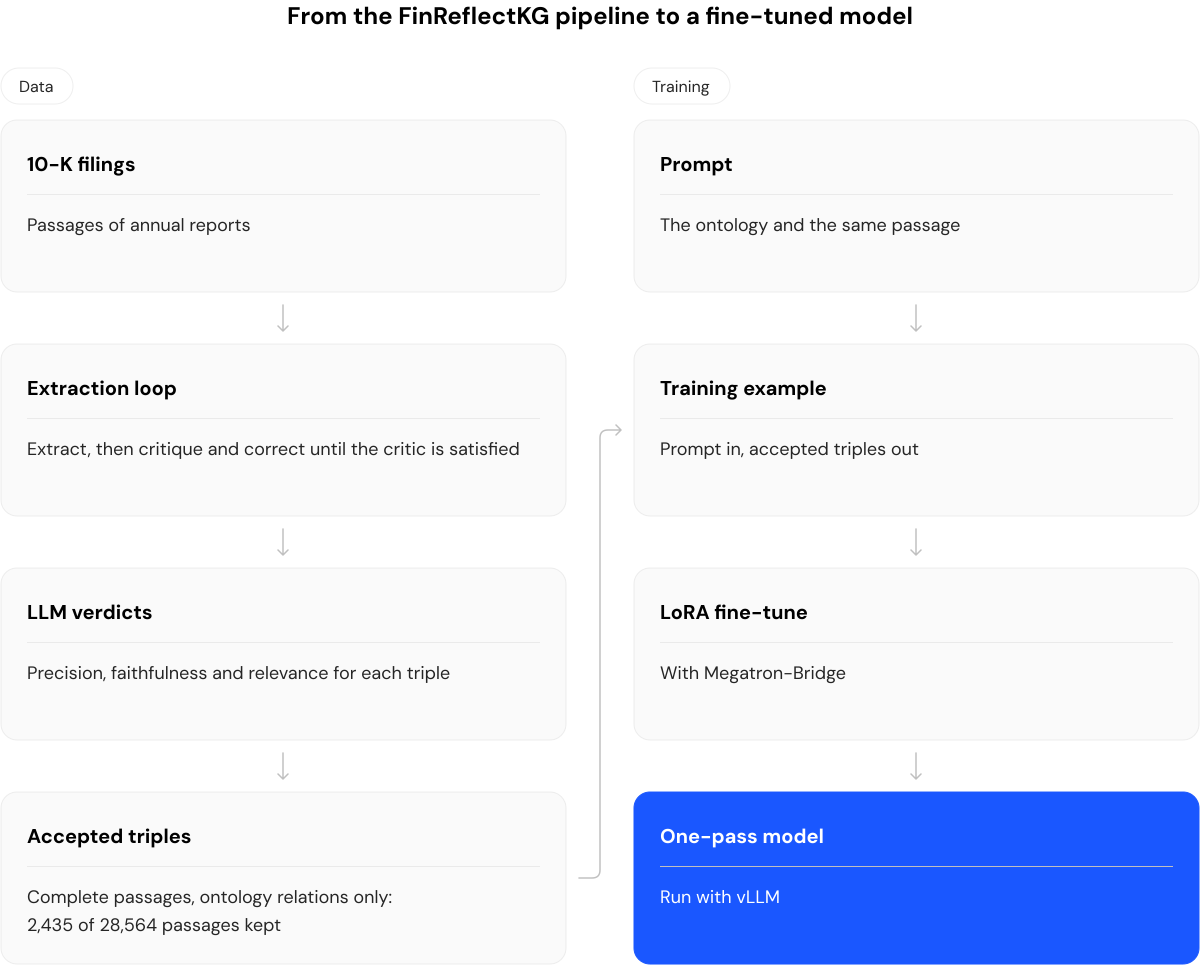
Dalla pipeline di FinReflectKG a un modello a ciclo unico.

‍

Lo stack di addestramento: Megatron-Bridge e vLLM

Abbiamo addestrato Nemotron 3.5 Super VL con la tecnica LoRA (low-rank adaptation): i pesi originali restano invariati e l’addestramento interviene solo su un piccolo insieme di pesi aggiuntivi. NVIDIA Megatron-Bridge offre una configurazione LoRA predefinita per Nemotron 3 Super, che si è rivelata compatibile senza modifiche anche con i pesi di Nemotron 3.5 Super VL. Abbiamo eseguito il modello base e quello specializzato su un cluster GPU tramite domyn-swarm, usando per entrambi la stessa versione di vLLM e la stessa distribuzione del modello sulle GPU. Domyn-swarm è il nostro strumento, disponibile pubblicamente, per eseguire vLLM su cluster gestiti con Slurm, uno scheduler di job molto diffuso nei supercomputer.

‍

Risultati

Un esempio su un documento reale

Questa porzione del 10-K 2024 di Bristol Myers Squibb è una tabella con gli importi pagati dall’azienda per un’acquisizione. Entrambi i modelli individuano le stesse sei voci, cambia solo la relazione che collega ciascuna voce all’azienda:
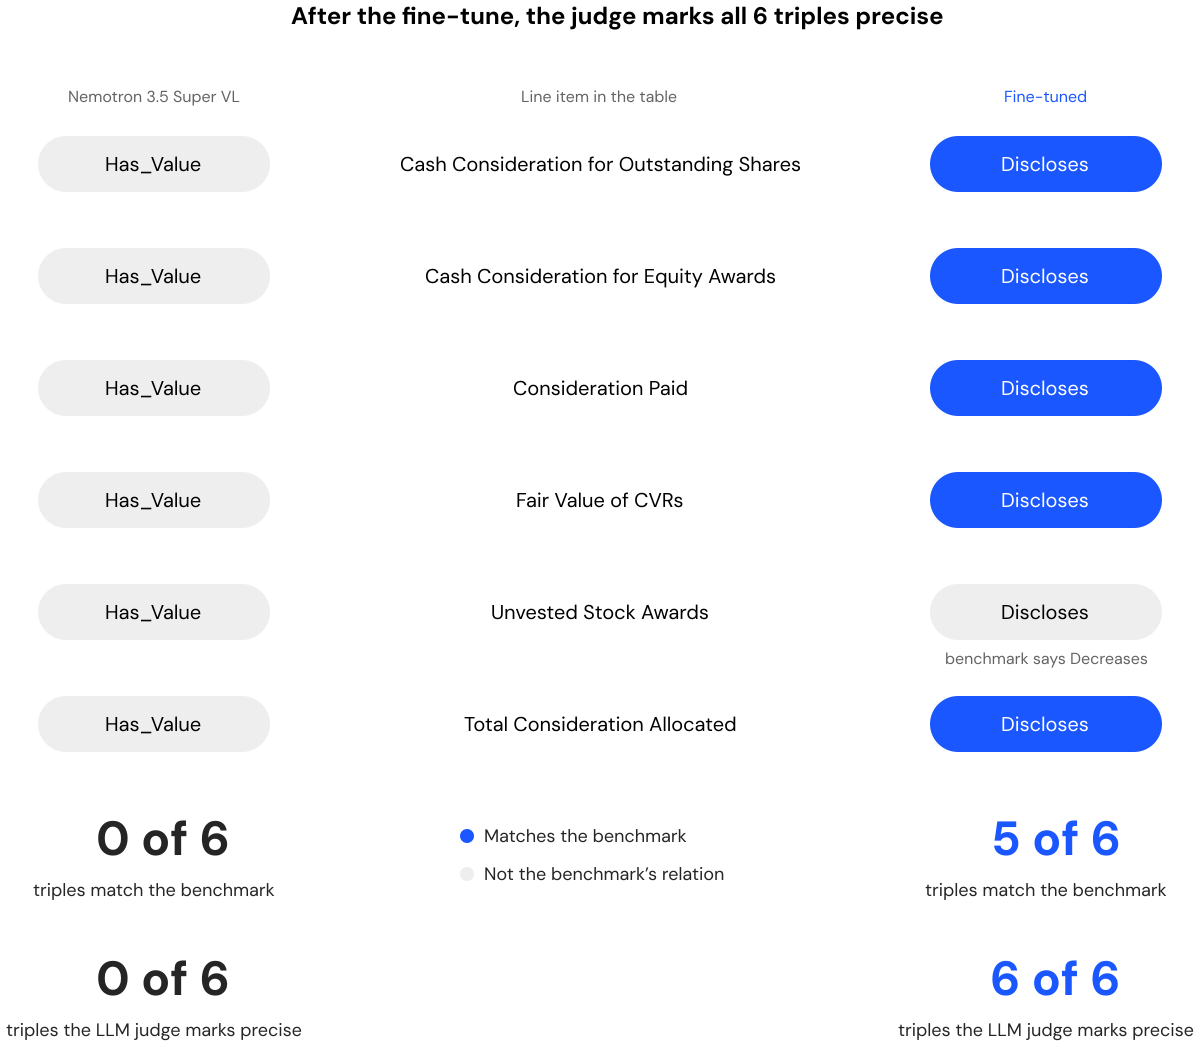
Diagram comparing Nemotron 3.5 Super VL before and after fine-tuning, showing benchmark triple matches improving from 0 of 6 to 5 of 6 and LLM-judged precision improving from 0 of 6 to 6 of 6.
Tabella dell’acquisizione di Bristol Myers Squibb. Il modello base collega le sei voci all’azienda con Has_Value, e il modello giudice non ne considera precisa nessuna. Il modello specializzato usa Discloses: il modello giudice considera precise tutte e sei le triple, e cinque sono conformi all’ontologia e alle sue convenzioni.

Il modello base collega ogni voce all’azienda usando “Has_Value”, una relazione generica. L’LLM giudice respinge tutte e sei le triple per mancanza di precisione, motivando la scelta con «relazione generica e valore mancante»: la tripla afferma che l’azienda ha un valore, ma non dice quale. Il modello specializzato usa invece “Discloses”, la relazione che i fatti di riferimento adottano per gli importi dichiarati. Poiché entrambe le relazioni sono ammesse, si tratta di una convenzione su cui l’ontologia non si pronuncia e che il modello specializzato coglie correttamente.

‍

Risultati sul test set

La stessa tendenza si osserva su tutte le 353 porzioni di test: la recall sulle triple raddoppia e anche le valutazioni del giudice migliorano. L’ultima colonna della tabella riporta l’intervallo di confidenza al 95% di ciascuna variazione:
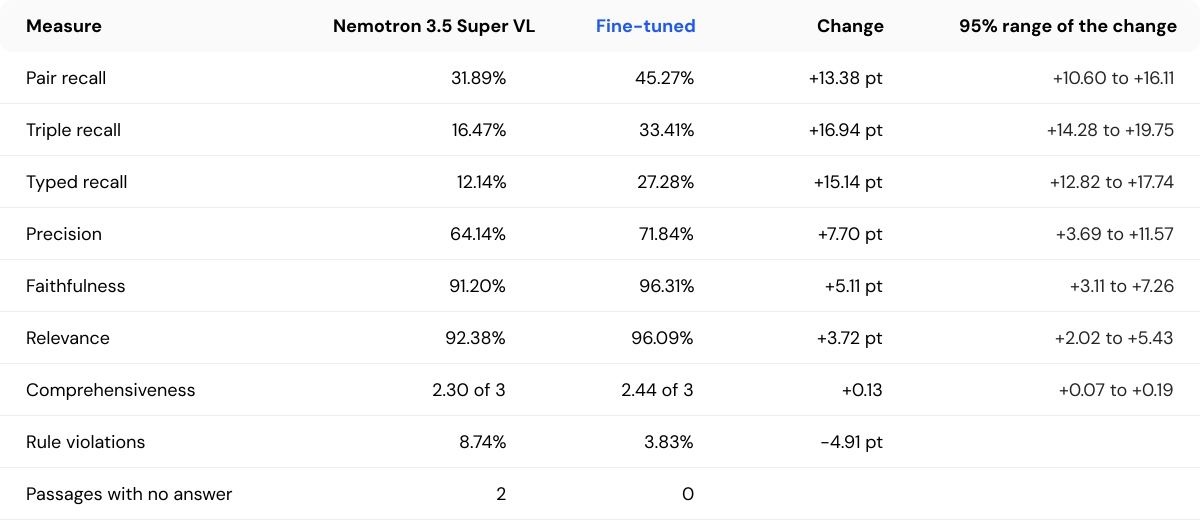
Table comparing Nemotron 3.5 Super VL before and after fine-tuning, showing improvements in recall, precision, faithfulness, relevance, and comprehensiveness, alongside fewer rule violations and unanswered passages.
Abbiamo calcolato ogni intervallo con un bootstrap appaiato, ricampionando 2.000 volte le porzioni di test. Recall e completezza sono calcolate su tutte le 353 porzioni; precisione, fedeltà e pertinenza sulle 345 porzioni valutate dal modello giudice in entrambe le esecuzioni. Per le porzioni senza risposta non è riportato alcun intervallo.

L’aumento della recall non è andato a scapito della precisione né della fedeltà. La recall sulle triple cresce più di quella sulle coppie: quando il modello specializzato individua la coppia giusta, sceglie più spesso anche la relazione usata dal benchmark, come nell’esempio di Bristol Myers Squibb.

Il modello specializzato riesce spesso a individuare fatti di riferimento dove il modello base falliva. Delle 124 porzioni in cui il modello base non ne aveva trovato nessuno, il modello specializzato ne individua almeno uno in 89, e almeno la metà in 36. Considerando tutte le porzioni, la sua recall sulle triple è più alta di quella del modello base in 224 casi e più bassa in 35.

I risultati illustrati finora mostrano che il modello specializzato supera nettamente il modello di partenza, Nemotron 3.5 Super VL. Allo stesso tempo, i valori assoluti indicano che un’estrazione completa non può essere svolta con una sola richiesta al modello: serve comunque un harness, cioè una pipeline a più fasi costruita attorno a esso. Da qui la domanda: su questo test set, i modelli chiusi più avanzati ottengono risultati migliori sotto questi aspetti, o incontrano limiti analoghi?

‍

Modelli chiusi sullo stesso test set

Per confrontare questi risultati con i modelli commerciali più usati come riferimento, abbiamo valutato nelle stesse condizioni due tra i modelli chiusi più performanti: GPT-6.1 Sol e Gemini 3.5 Flash, sulle stesse 353 porzioni di test, con lo stesso prompt e lo stesso sistema di valutazione. Nessuno dei due modelli consente di disattivare il ragionamento, quindi li abbiamo impostati al livello minimo documentato: low per Sol e minimal per Flash. Abbiamo poi ripetuto il test al livello predefinito, medium. Le richieste sono state inviate tramite un endpoint compatibile con OpenAI che non consente di impostare la temperatura: i modelli chiusi hanno quindi operato con il valore predefinito del fornitore.
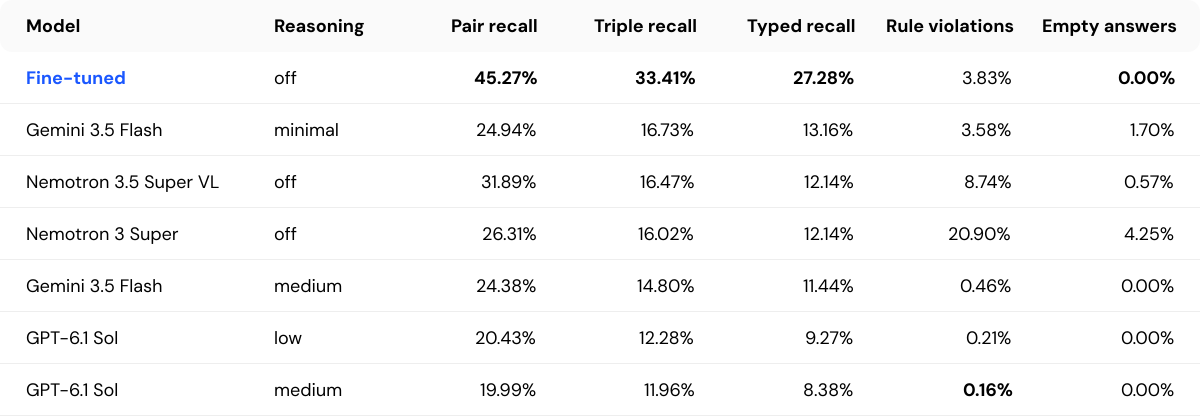
Table comparing seven model configurations for financial knowledge graph extraction, showing the fine-tuned model achieving the highest pair, triple, and typed recall, with zero empty answers, alongside rule violation rates and reasoning settings.
Recall, violazioni delle regole e risposte vuote del modello specializzato, dei due modelli base Nemotron e dei due modelli chiusi sulle stesse 353 porzioni di test, ordinati per recall sulle triple. Il modello specializzato ottiene la recall più alta in tutte le colonne; i modelli chiusi violano meno regole.

Il modello specializzato raggiunge una recall sulle triple doppia rispetto al miglior risultato dei modelli chiusi. Al livello low, GPT-6.1 Sol è superato su tutti i livelli di recall già dal modello base Nemotron 3.5 Super VL, con una recall sulle triple più bassa di 4,20 punti (intervallo di confidenza al 95%: da 1,75 a 6,69). Entrambi i modelli chiusi registrano meno violazioni delle regole. Più ragionamento, però, non si traduce in più recall: entrambi ottengono punteggi più bassi al livello medium che a quello minimo.

‍

Risultati su settori assenti dal training set

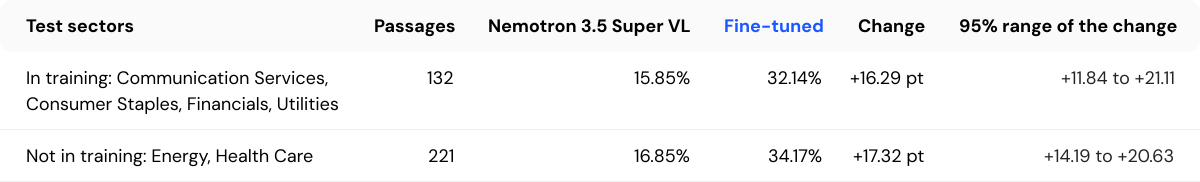
Il fine-tuning migliora la recall sulle triple anche nei settori non inclusi nell’addestramento. Su due aziende di test, ciascuna appartenente a un nuovo settore (sanità ed energia), la recall sulle triple sale dal 17% di Nemotron 3.5 Super VL al 34%, contro un aumento dal 16% al 32% nei quattro settori coperti dall’addestramento.
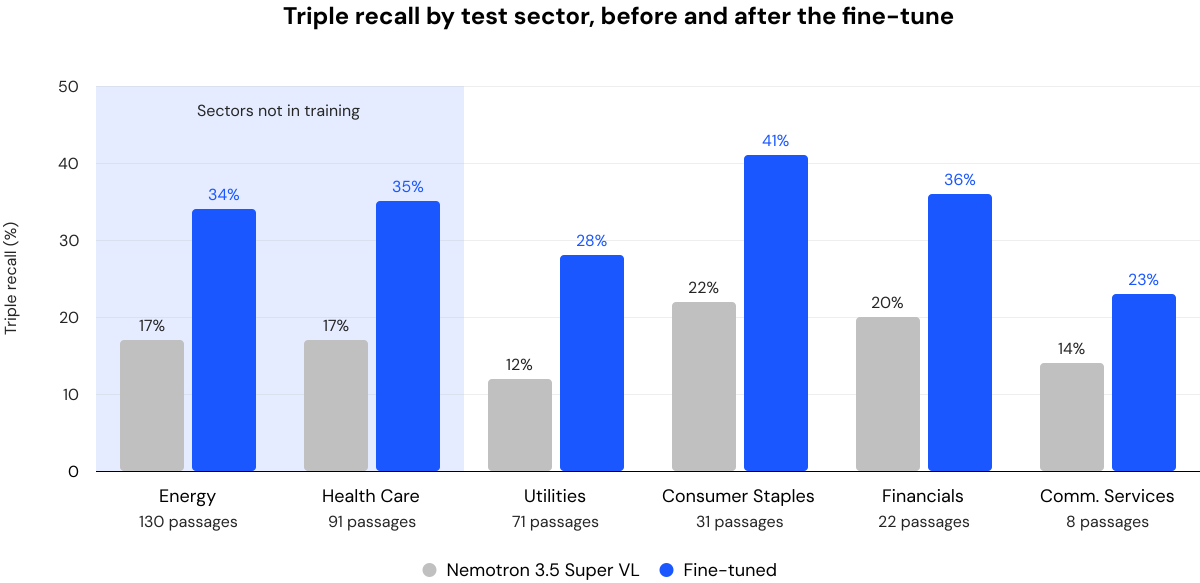
Bar chart comparing triple recall across six financial sectors before and after fine-tuning, showing improvements in every sector, including sectors excluded from training, with recall increasing from 12–22% to 23–41%.
Recall sulle triple per settore di test, prima e dopo il fine-tuning. Per ogni coppia, la barra di sinistra indica Nemotron 3.5 Super VL prima del fine-tuning, quella di destra il modello specializzato. I settori ombreggiati non compaiono nei set di addestramento e di validazione. Ogni settore comprende una o due aziende di test.

‍

Table comparing Nemotron 3.5 Super VL before and after fine-tuning across financial sectors included in and excluded from training, showing recall improvements of 16.29 and 17.32 percentage points, respectively, with 95% confidence ranges.

‍

Conclusioni: il valore di un fine-tuning mirato

Con soli 1.978 esempi di addestramento, il fine-tuning di NVIDIA Nemotron 3.5 Super VL ha raddoppiato la recall sulle triple, migliorato precisione e fedeltà e ridotto di oltre la metà le violazioni delle regole. I miglioramenti si sono estesi anche ad aziende e settori non coperti dall’addestramento. I risultati confermano il valore della specializzazione nell’estrazione di informazioni in ambito finanziario: significa insegnare a un modello non solo a individuare i fatti, ma anche a esprimerli rispettando la struttura richiesta da un knowledge graph basato su un’ontologia specifica. Dimostrano inoltre che anche un compito circoscritto e ben definito può trarre vantaggi significativi da un fine-tuning mirato, con una quantità limitata di dati di alta qualità.

‍

Ringraziamenti

Ringraziamo NVIDIA per Nemotron 3.5 Super VL e Megatron-Bridge, gli autori del progetto vLLM e di FinReflectKG per i dati pubblici e il benchmark.

‍

Risorse

Domande frequenti

No items found.
en

Specializzare NVIDIA Nemotron 3.5 Super VL per migliorare l’estrazione di knowledge graph finanziari

iGenius
October 15, 2026
·
14 min

I knowledge graph forniscono proprio questa struttura e sono ormai una componente chiave per fondare su dati verificabili il ragionamento degli agenti AI in ambito finanziario. Consentono così agli utenti di orientarsi in scenari finanziari complessi con il supporto di agenti AI le cui risposte sono sempre riconducibili a fonti verificate, a garanzia della loro affidabilità e della conformità normativa.

Costruire knowledge graph con un approccio agentico richiede diverse fasi, come abbiamo descritto nel paper FinReflectKG: individuare i fatti potenzialmente rilevanti, verificarli e strutturare quelli confermati in triple, ovvero coppie di entità unite da una relazione. L’efficacia di queste pipeline agentiche dipende dalla capacità del modello sottostante di svolgere ciascuna fase sulle porzioni di un 10-K, sia separatamente sia combinandole in un’unica richiesta.

Perché un knowledge graph possa collegare informazioni provenienti da porzioni e documenti diversi, riconoscere i fatti è solo una parte del lavoro. Il modello deve anche esprimerli in modo coerente, usando per entità e relazioni i nomi previsti dall’ontologia, cioè dallo schema che organizza la conoscenza.

Per migliorare la precisione e la recall dei modelli nell’estrazione di informazioni strutturate secondo un’ontologia specifica, abbiamo eseguito il fine-tuning di NVIDIA Nemotron 3.5 Super VL perché leggesse una porzione di un documento 10-K e ne estraesse i fatti sotto forma di triple strutturate, come (NKE, Discloses, Revenue). Abbiamo addestrato il modello con NVIDIA Megatron-Bridge e le sue configurazioni di addestramento predefinite, e lo abbiamo eseguito con vLLM per la valutazione.

Il flusso di lavoro che abbiamo messo a punto mostra come si possa specializzare un modello su sottodomini e compiti specifici. In questo caso, abbiamo testato il modello sui documenti di sette aziende mai viste in addestramento, valutando gli output in base all’ontologia pubblica di FinReflectKG. I risultati mostrano che il modello specializzato individua più fatti di riferimento e li esprime in modo coerente con l’ontologia richiesta.

 Nello specifico, il modello specializzato:

  • individua il doppio dei fatti di riferimento del benchmark con un solo ciclo di estrazione, passando dal 16% al 33%, e supera sia il modello di partenza sia i modelli chiusi più avanzati nello stesso compito;
  • produce in media una quota più alta di triple corrette per porzione, secondo la valutazione di un LLM giudice: dal 64% al 72%;
  • migliora in misura analoga anche nei settori non inclusi nell’addestramento: nell’ambito dell’energia e della sanità, con un’azienda di test ciascuno, la quota di fatti di riferimento individuati cresce di 17 punti;
  • commette meno della metà delle violazioni delle regole, che riguardano il 3,8% delle triple anziché l’8,7%.

Questi risultati sono stati ottenuti con soli 1.978 esempi di addestramento: un insieme relativamente ridotto, che rende il processo replicabile su altri casi d’uso con costi e tempi contenuti.

Nelle sezioni seguenti descriviamo nel dettaglio la metodologia e i risultati, con un esempio concreto tratto da un documento finanziario.

‍

Costruire knowledge graph dai documenti 10-K

Costruire un knowledge graph a partire dai documenti 10-K significa individuare ed estrarre fatti del tipo "quale azienda produce cosa", "quale segmento genera quali ricavi”, "quale rischio incide su quale attività". La pipeline pubblica di FinReflectKG suddivide ogni documento in porzioni di pochi paragrafi o di una sola tabella, di circa 330 parole (valore mediano). Estrae poi i fatti di ciascuna porzione attraverso più chiamate a un LLM: un’estrazione, seguita da cicli di critica e correzione. Ogni fatto si basa su un elenco fisso di relazioni e tipi di entità ammessi, e i fatti provenienti da documenti diversi confluiscono in un knowledge graph globale. Il nostro obiettivo era eseguire il fine-tuning di Nemotron 3.5 Super VL per migliorare l’estrazione zero-shot, cioè senza esempi nel prompt, secondo ontologie specifiche.

‍

Metriche di valutazione

Le prestazioni del modello base e del modello specializzato sono state valutate secondo la seguente metodologia.

La recall è la quota di fatti di riferimento del benchmark che il modello riesce a individuare. I fatti di riferimento sono le triple che il benchmark considera corrette, generate dalla pipeline di FinReflectKG tramite LLM. La recall prevede tre livelli di rigore: la recall sulle coppie (pair recall) richiede l’individuazione delle due entità di un fatto di riferimento; la recall sulle triple (triple recall) richiede anche la relazione corretta tra le due entità; la recall tipizzata (typed recall) richiede infine la categoria di ciascuna entità. Ogni recall è calcolata come media su tutte le porzioni.

Un LLM giudice è un secondo modello linguistico che valuta l’output in base alla griglia di valutazione del benchmark. Abbiamo scelto Qwen3-32B, lo stesso modello adottato nel nostro articolo sulla costruzione di FinReflectKG, e gli abbiamo fornito i prompt di valutazione di FinReflectKG-EvalBench, in una configurazione a giudice singolo. Per ogni tripla il modello giudice assegna tre valutazioni: precisione (il fatto è corretto), fedeltà (il testo lo supporta) e pertinenza (il fatto è rilevante per il documento). Per l’intera porzione,  il modello giudice assegna un punteggio da 1 a 3 che misura quanta parte del contenuto è coperta dalle triple (completezza). Ogni punteggio assegnato è una media su tutte le porzioni. I risultati finali sono stati inoltre verificati tramite una valutazione umana.

Una tripla presenta una violazione delle regole quando infrange almeno una delle regole indicate nel prompt di estrazione fornito al modello: una regola dell’ontologia, come usare solo le relazioni ammesse o indicare l’azienda emittente con il suo ticker (NKE per Nike), oppure una regola di formato, come rispettare la lunghezza massima dei nomi delle entità. Il tasso di violazione è la quota di triple con almeno una violazione.

Diagram showing three evaluation methods for financial knowledge graph extraction: rule violations, recall against FinReflectKG reference facts, and LLM judge assessments of precision, faithfulness, relevance, and comprehensiveness, with 95% confidence ranges.
Il sistema di valutazione: violazioni delle regole, recall e LLM giudice

‍

Il nostro metodo di lavoro

Il punto di partenza: Nemotron 3.5 Super VL

Nemotron 3.5 Super VL, della famiglia Nemotron di NVIDIA, è il successore di Nemotron 3 Super. Già prima dell’addestramento, supera il suo predecessore sulle stesse 353 porzioni di test:

Comparison table showing Nemotron 3.5 Super VL outperforming Nemotron 3 Super in financial knowledge graph extraction, with higher pair and triple recall, better comprehensiveness, fewer rule violations, and fewer passages with no answer.

Rispetto al suo predecessore, Nemotron 3.5 Super VL individua più coppie di entità corrette, estrae da ogni porzione un numero maggiore di informazioni e ha un tasso di violazione inferiore alla metà. 

Il modello base non usa le etichette dell’ontologia, e la sua recall sulle triple si ferma infatti al 16%. Quando Nemotron 3.5 Super VL non individua un fatto di riferimento, di solito riconosce correttamente l’azienda, ma denomina l’altra entità in modo diverso dal benchmark oppure la omette.

Diagram comparing entity and relation names generated by Nemotron 3.5 Super VL with fine-tuned reference names for financial knowledge graph extraction, highlighting naming differences across Faces, Competes_With, and Discloses relationships.
Il modello base denomina le entità in modo diverso dalla nomenclatura dell’ontologia. Confronto fra tre fatti non individuati: il nome usato dal modello base accanto a quello del benchmark, adottato dal modello specializzato.

Nemotron 3.5 Super VL dispone già delle conoscenze generali necessarie per questo compito. Con il fine-tuning, però, siamo riusciti a insegnargli ad applicare le regole dell’ontologia durante l’estrazione.

I dati di addestramento

Siamo partiti da FinReflectKG-EvalBench, la versione del nostro dataset FinReflectKG dedicata alla valutazione, e ne abbiamo estratto un sottoinsieme di esempi come training set, mantenendolo separato dall’insieme usato per la valutazione. A differenza del dataset principale, FinReflectKG-EvalBench associa a ogni tripla i giudizi di un LLM valutatore su precisione, fedeltà e pertinenza. Abbiamo considerato solo le 38 aziende per cui almeno il 30% delle triple ha superato tutti e tre i giudizi, perché un tasso inferiore indica una valutazione non riuscita. Tra queste, abbiamo selezionato le 2.435 porzioni che soddisfacevano tre criteri: punteggio di completezza massimo, almeno il 70% delle triple con esito positivo in tutti e tre i giudizi e solo relazioni comprese tra le 51 dell’ontologia. Queste porzioni rappresentano il 32% di tutte le porzioni con fatti di riferimento disponibili per quelle aziende.

Ogni porzione, insieme alle relative triple accettate, costituisce un esempio di addestramento. Abbiamo suddiviso gli esempi per azienda, in modo che il test avvenisse su aziende che il modello non aveva mai visto. Questa suddivisione è diversa da quella riportata nei nostri articoli su FinReflectKG, quindi i risultati non sono direttamente confrontabili con quelli pubblicati. Il validation set è un piccolo insieme di esempi tenuto da parte e usato per monitorare l’addestramento:

Table showing training, validation, and test dataset splits for financial knowledge graph extraction, with 1,978, 104, and 353 passages respectively, alongside company counts and reference facts for each split.

Due settori di test, energia e sanità, non hanno alcuna azienda nei set di addestramento e di validazione.

Dalla pipeline di FinReflectKG a un modello a ciclo unico.

‍

Lo stack di addestramento: Megatron-Bridge e vLLM

Abbiamo addestrato Nemotron 3.5 Super VL con la tecnica LoRA (low-rank adaptation): i pesi originali restano invariati e l’addestramento interviene solo su un piccolo insieme di pesi aggiuntivi. NVIDIA Megatron-Bridge offre una configurazione LoRA predefinita per Nemotron 3 Super, che si è rivelata compatibile senza modifiche anche con i pesi di Nemotron 3.5 Super VL. Abbiamo eseguito il modello base e quello specializzato su un cluster GPU tramite domyn-swarm, usando per entrambi la stessa versione di vLLM e la stessa distribuzione del modello sulle GPU. Domyn-swarm è il nostro strumento, disponibile pubblicamente, per eseguire vLLM su cluster gestiti con Slurm, uno scheduler di job molto diffuso nei supercomputer.

‍

Risultati

Un esempio su un documento reale

Questa porzione del 10-K 2024 di Bristol Myers Squibb è una tabella con gli importi pagati dall’azienda per un’acquisizione. Entrambi i modelli individuano le stesse sei voci, cambia solo la relazione che collega ciascuna voce all’azienda:

Diagram comparing Nemotron 3.5 Super VL before and after fine-tuning, showing benchmark triple matches improving from 0 of 6 to 5 of 6 and LLM-judged precision improving from 0 of 6 to 6 of 6.
Tabella dell’acquisizione di Bristol Myers Squibb. Il modello base collega le sei voci all’azienda con Has_Value, e il modello giudice non ne considera precisa nessuna. Il modello specializzato usa Discloses: il modello giudice considera precise tutte e sei le triple, e cinque sono conformi all’ontologia e alle sue convenzioni.

Il modello base collega ogni voce all’azienda usando “Has_Value”, una relazione generica. L’LLM giudice respinge tutte e sei le triple per mancanza di precisione, motivando la scelta con «relazione generica e valore mancante»: la tripla afferma che l’azienda ha un valore, ma non dice quale. Il modello specializzato usa invece “Discloses”, la relazione che i fatti di riferimento adottano per gli importi dichiarati. Poiché entrambe le relazioni sono ammesse, si tratta di una convenzione su cui l’ontologia non si pronuncia e che il modello specializzato coglie correttamente.

‍

Risultati sul test set

La stessa tendenza si osserva su tutte le 353 porzioni di test: la recall sulle triple raddoppia e anche le valutazioni del giudice migliorano. L’ultima colonna della tabella riporta l’intervallo di confidenza al 95% di ciascuna variazione:

Table comparing Nemotron 3.5 Super VL before and after fine-tuning, showing improvements in recall, precision, faithfulness, relevance, and comprehensiveness, alongside fewer rule violations and unanswered passages.
Abbiamo calcolato ogni intervallo con un bootstrap appaiato, ricampionando 2.000 volte le porzioni di test. Recall e completezza sono calcolate su tutte le 353 porzioni; precisione, fedeltà e pertinenza sulle 345 porzioni valutate dal modello giudice in entrambe le esecuzioni. Per le porzioni senza risposta non è riportato alcun intervallo.

L’aumento della recall non è andato a scapito della precisione né della fedeltà. La recall sulle triple cresce più di quella sulle coppie: quando il modello specializzato individua la coppia giusta, sceglie più spesso anche la relazione usata dal benchmark, come nell’esempio di Bristol Myers Squibb.

Il modello specializzato riesce spesso a individuare fatti di riferimento dove il modello base falliva. Delle 124 porzioni in cui il modello base non ne aveva trovato nessuno, il modello specializzato ne individua almeno uno in 89, e almeno la metà in 36. Considerando tutte le porzioni, la sua recall sulle triple è più alta di quella del modello base in 224 casi e più bassa in 35.

I risultati illustrati finora mostrano che il modello specializzato supera nettamente il modello di partenza, Nemotron 3.5 Super VL. Allo stesso tempo, i valori assoluti indicano che un’estrazione completa non può essere svolta con una sola richiesta al modello: serve comunque un harness, cioè una pipeline a più fasi costruita attorno a esso. Da qui la domanda: su questo test set, i modelli chiusi più avanzati ottengono risultati migliori sotto questi aspetti, o incontrano limiti analoghi?

‍

Modelli chiusi sullo stesso test set

Per confrontare questi risultati con i modelli commerciali più usati come riferimento, abbiamo valutato nelle stesse condizioni due tra i modelli chiusi più performanti: GPT-6.1 Sol e Gemini 3.5 Flash, sulle stesse 353 porzioni di test, con lo stesso prompt e lo stesso sistema di valutazione. Nessuno dei due modelli consente di disattivare il ragionamento, quindi li abbiamo impostati al livello minimo documentato: low per Sol e minimal per Flash. Abbiamo poi ripetuto il test al livello predefinito, medium. Le richieste sono state inviate tramite un endpoint compatibile con OpenAI che non consente di impostare la temperatura: i modelli chiusi hanno quindi operato con il valore predefinito del fornitore.

Table comparing seven model configurations for financial knowledge graph extraction, showing the fine-tuned model achieving the highest pair, triple, and typed recall, with zero empty answers, alongside rule violation rates and reasoning settings.
Recall, violazioni delle regole e risposte vuote del modello specializzato, dei due modelli base Nemotron e dei due modelli chiusi sulle stesse 353 porzioni di test, ordinati per recall sulle triple. Il modello specializzato ottiene la recall più alta in tutte le colonne; i modelli chiusi violano meno regole.

Il modello specializzato raggiunge una recall sulle triple doppia rispetto al miglior risultato dei modelli chiusi. Al livello low, GPT-6.1 Sol è superato su tutti i livelli di recall già dal modello base Nemotron 3.5 Super VL, con una recall sulle triple più bassa di 4,20 punti (intervallo di confidenza al 95%: da 1,75 a 6,69). Entrambi i modelli chiusi registrano meno violazioni delle regole. Più ragionamento, però, non si traduce in più recall: entrambi ottengono punteggi più bassi al livello medium che a quello minimo.

‍

Risultati su settori assenti dal training set

Il fine-tuning migliora la recall sulle triple anche nei settori non inclusi nell’addestramento. Su due aziende di test, ciascuna appartenente a un nuovo settore (sanità ed energia), la recall sulle triple sale dal 17% di Nemotron 3.5 Super VL al 34%, contro un aumento dal 16% al 32% nei quattro settori coperti dall’addestramento.

Bar chart comparing triple recall across six financial sectors before and after fine-tuning, showing improvements in every sector, including sectors excluded from training, with recall increasing from 12–22% to 23–41%.
Recall sulle triple per settore di test, prima e dopo il fine-tuning. Per ogni coppia, la barra di sinistra indica Nemotron 3.5 Super VL prima del fine-tuning, quella di destra il modello specializzato. I settori ombreggiati non compaiono nei set di addestramento e di validazione. Ogni settore comprende una o due aziende di test.

‍

Table comparing Nemotron 3.5 Super VL before and after fine-tuning across financial sectors included in and excluded from training, showing recall improvements of 16.29 and 17.32 percentage points, respectively, with 95% confidence ranges.

‍

Conclusioni: il valore di un fine-tuning mirato

Con soli 1.978 esempi di addestramento, il fine-tuning di NVIDIA Nemotron 3.5 Super VL ha raddoppiato la recall sulle triple, migliorato precisione e fedeltà e ridotto di oltre la metà le violazioni delle regole. I miglioramenti si sono estesi anche ad aziende e settori non coperti dall’addestramento. I risultati confermano il valore della specializzazione nell’estrazione di informazioni in ambito finanziario: significa insegnare a un modello non solo a individuare i fatti, ma anche a esprimerli rispettando la struttura richiesta da un knowledge graph basato su un’ontologia specifica. Dimostrano inoltre che anche un compito circoscritto e ben definito può trarre vantaggi significativi da un fine-tuning mirato, con una quantità limitata di dati di alta qualità.

‍

Ringraziamenti

Ringraziamo NVIDIA per Nemotron 3.5 Super VL e Megatron-Bridge, gli autori del progetto vLLM e di FinReflectKG per i dati pubblici e il benchmark.

‍

Risorse

Share this post
Scopri le ultime novità di iGenius
Ricevi le ultime notizie dal mondo dell'AI e aggiornamenti sui nostri prodotti.